Mihu Voice este propriul nostru stack vocal, creat pentru apeluri live: Umay transformă vorbirea în text în timp ce apelantul încă vorbește, iar Ses transformă textul în vorbire naturală în șapte limbi. Un singur API, găzduit în Europa sau Turcia ori pe propriile tale servere.
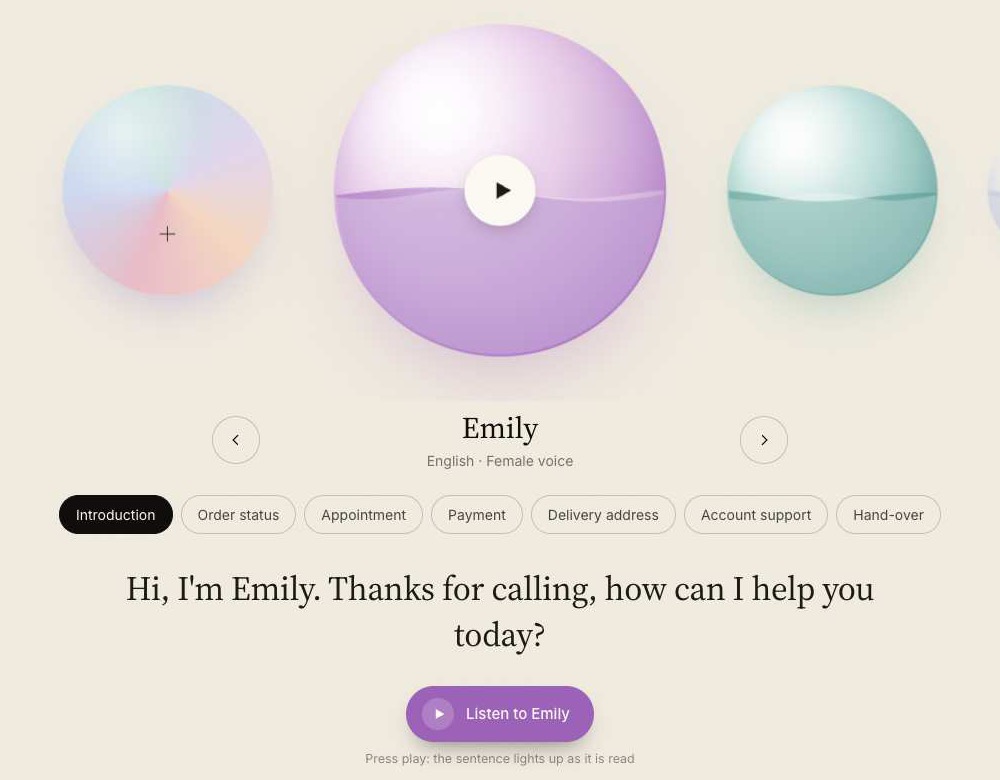
mihu-umay-v1 pentru vorbire în text și mihu-ses-v1 pentru text în vorbire funcționează cu o singură cheie API, prin REST și WebSocket. Ambele răspund la fel în fiecare regiune și funcționează cu SDK-urile oficiale OpenAI schimbând doar base URL-ul.
Textul parțial vine în streaming pe măsură ce persoana vorbește. Propoziția finală e gata la circa 80 ms după ce se oprește, mai repede decât o clipire, așa că agentul tău poate răspunde fără pauză.
Pe vorbire citită în turcă, Umay are o rată de eroare a cuvintelor de 3.42%, cea mai mică dintre cele nouă sisteme testate de noi. În modul doar turcă, un singur server gestionează până la 256 de apeluri live.
Opțiunile pentru vorbitori se activează per cerere; dezactivate, nu adaugă latență.
model=umaymodel=umay-streamwebhook_urlnormalizehints, hint_contextmode=normalgender_detectiondiarizespeaker_lockvoice_isolationreference_voiceprintPOST /v1/voiceprints/verifyPOST /v1/audio/isolationSumele, datele și numerele de înmatriculare sunt scrise cu cifre, cu circa 6 ms în plus. Listele integrate de districte și cartiere, plus propriile tale hotwords, cresc acuratețea numelor de locuri în apelurile live cu 3 până la 8 puncte.
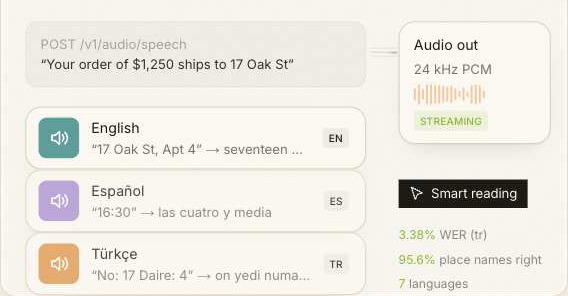
Ses citește adrese, nume de locuri, sume, date, numere de înmatriculare și numere de telefon așa cum le spun oamenii, în toate cele șapte limbi. Sunetul vine înapoi în streaming înainte ca întreaga propoziție să fie sintetizată și pornește în circa 0.1 s.
Înregistrează o mostră scurtă, iar Ses creează o voce personalizată pe care o poți folosi alături de cele 22 de voci incluse. Fiecare clonă trece printr-o verificare de citire și necesită acordul vorbitorului. Înregistrarea e folosită pentru a crea vocea și apoi ștearsă; se păstrează doar vocea.
Clonează o voce în consolăFiecare sistem este evaluat la fel pe seturi de test publice, cu numere și formate normalizate. O rată de eroare a cuvintelor mai mică este mai bună.
| Limbă | Rata de eroare a cuvintelor | Acuratețea cuvintelor |
|---|---|---|
| Türkçe | 3.42% | 96.58% |
| English | 6.44% | 93.56% |
| Deutsch | 6.46% | 93.54% |
| Français | 6.70% | 93.30% |
| Español | 3.68% | 96.32% |
| Italiano | 3.34% | 96.66% |
| Русский | 5.61% | 94.39% |
| Limbă | Rata de eroare a cuvintelor | Acuratețea cuvintelor |
|---|---|---|
| Türkçe | 3.38% | 96.62% |
| English | 1.29% | 98.71% |
| Deutsch | 3.62% | 96.38% |
| Français | 4.41% | 95.59% |
| Español | 2.53% | 97.47% |
| Italiano | 3.36% | 96.64% |
| Русский | 5.04% | 94.96% |
Turca este măsurată și pe apeluri telefonice și emisiuni. Metodele, toate sistemele testate și graficele complete sunt pe pagina de benchmarkuri. Toate benchmarkurile →
Testează voci, transcrie, clonează și gestionează chei fără să scrii cod. Și tu decizi cât timp rămâne stocat orice.
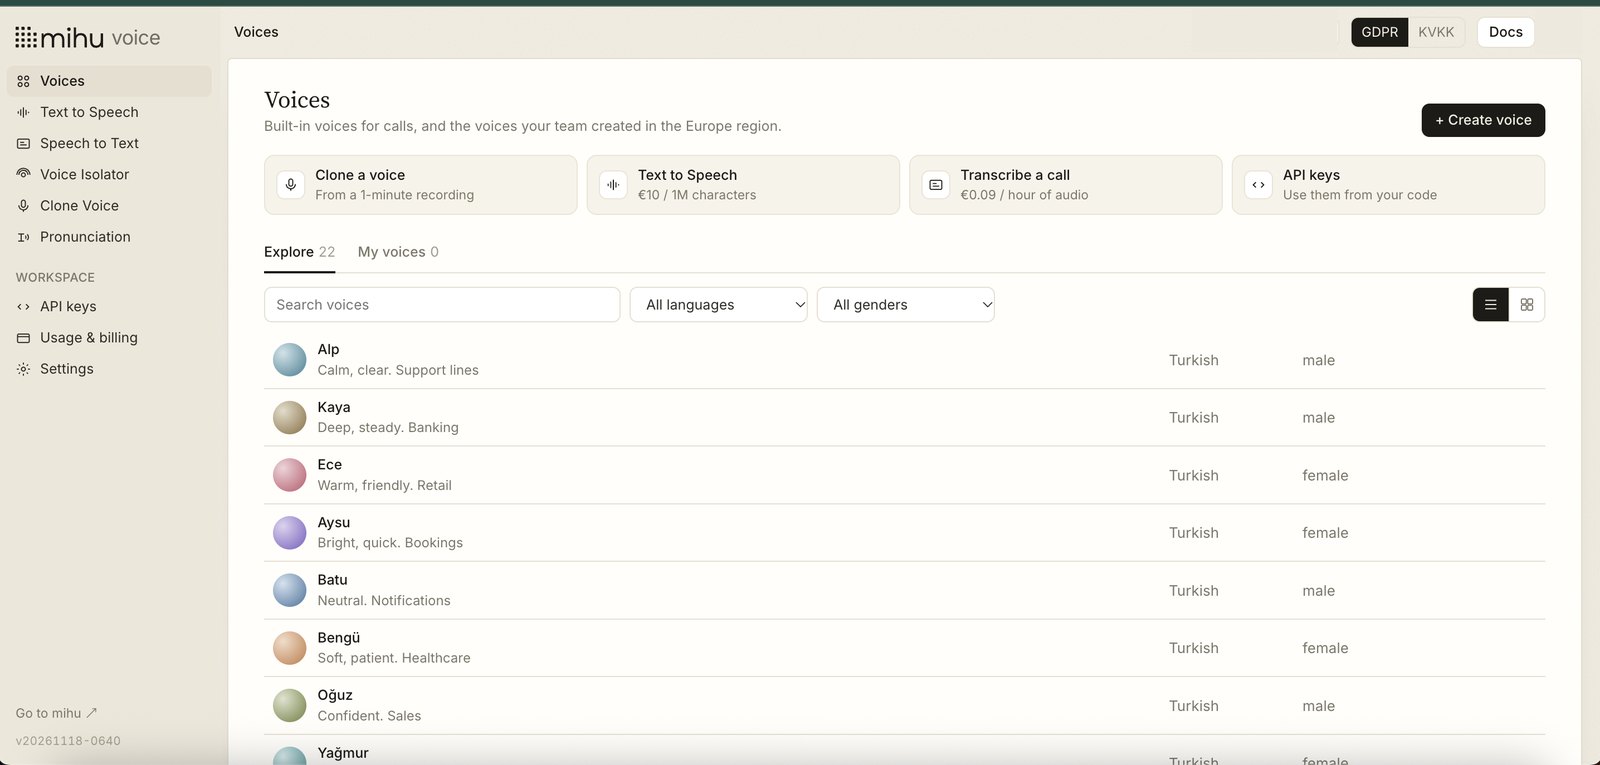
Vocile incluse și vocile tale. Ascultă oricare dintre ele înainte să o folosești.
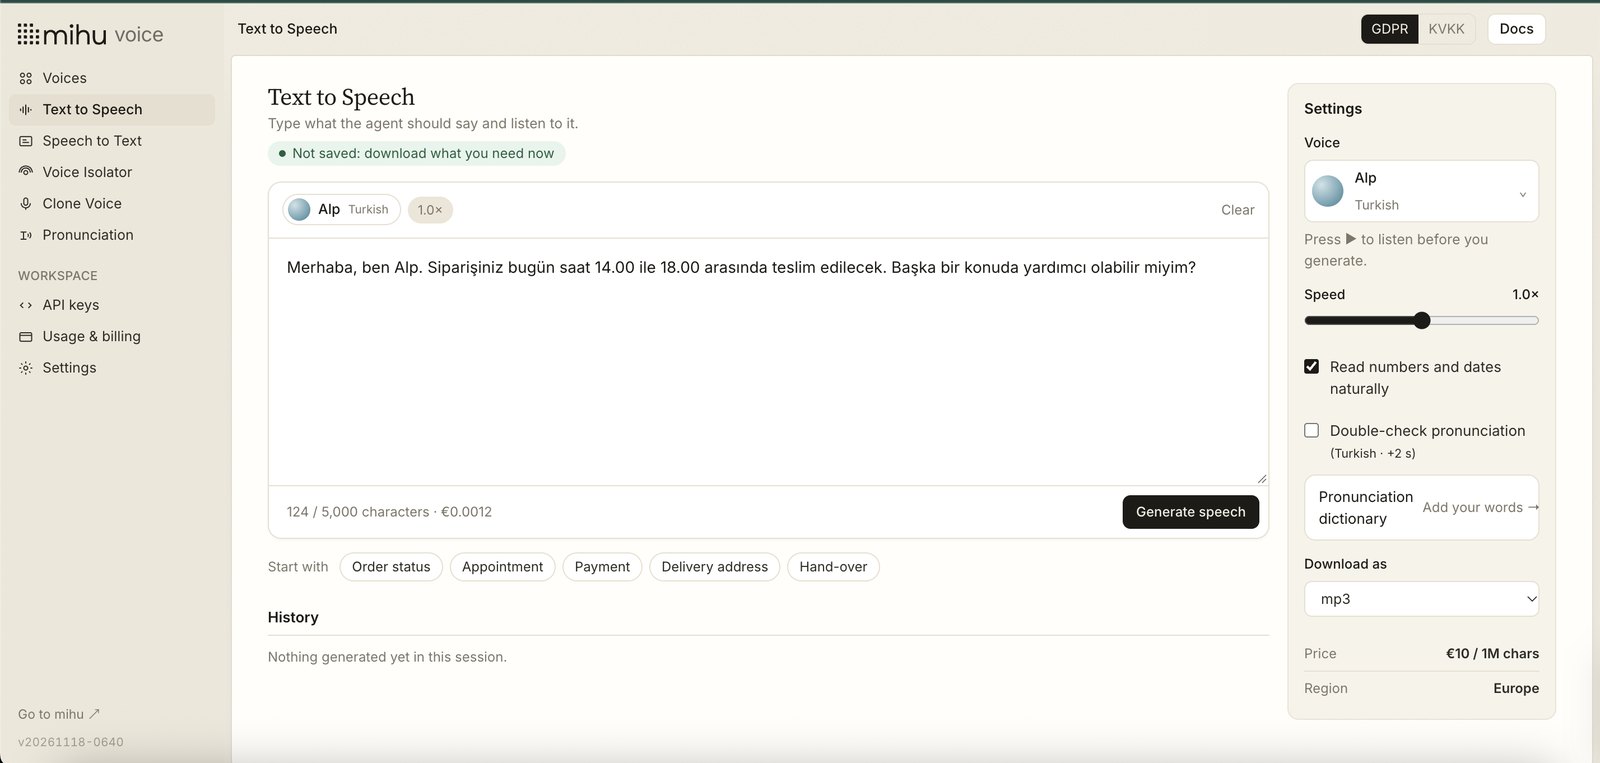
Scrie, alege o voce și auzi-o pornind în circa 0.1 s. Descarcă în mp3, wav, flac și altele.
Încarcă un fișier sau un link, înregistrează sau treci pe live și vezi cuvintele apărând pe măsură ce vorbești.
Elimină vocile de fundal și zgomotul dintr-o înregistrare; compară înainte și după.
O voce din 10–30 de secunde de vorbire, cu verificare de citire și acordul vorbitorului.
Chei pentru serverele tale, cod de pornire rapidă pentru fiecare regiune și cât ai cheltuit.
Nu ai nevoie de niciun SDK Mihu și nu rulează nimic la tine. Apelurile live transmit audio printr-un WebSocket; fișierele și sinteza folosesc HTTPS simplu. Alegerea regiunii schimbă doar hostul.
import asyncio, json, websockets

URL = "wss://stt.eu.mihu.ai/v1/stream?model=umay-stream&language=tr&api_key=KEY"

async def transcribe(chunks):  # 100 ms of 16 kHz mono int16 PCM
    async with websockets.connect(URL, max_size=None) as ws:
        async def read():
            async for m in ws:
                d = json.loads(m)
                if d["type"] == "final":
                    print(d["text"])  # send this to your LLM
        reader = asyncio.create_task(read())
        for chunk in chunks:
            await ws.send(chunk)
        await ws.send(json.dumps({"event": "end"}))
await readerStreamurile live sunt procesate în memorie și nu sunt scrise niciodată pe disc. Un fișier este păstrat doar cât timp este transcris.
Rezultatele API îți sunt returnate, nu păstrate. În consolă alegi cât timp rămân transcrierile, de la deloc până la 3 ani.
Înregistrările vocale nu sunt stocate niciodată. Se păstrează doar o semnătură numerică, și doar dacă o ceri; poate fi ștearsă definitiv.
Prețuri de listă în euro. Opțiunile se facturează separat, doar când le folosești. Fișierele și streamurile live costă la fel.
| Sarcină | Volum | Cost |
|---|---|---|
| Transcrierea a 10,000 de apeluri de 3 minute | 500 de ore de audio | €45.00 |
| Rostirea a 10,000 de răspunsuri de 200 de caractere | 2 milioane de caractere | €20.00 |
| Transcrierea a 1,000 de ore de înregistrări | 1,000 de ore de audio | €90.00 |
| 10,000 de apeluri de 3 minute cu diarizarea vorbitorilor | 500 de ore + 10,000 de conversații | €145.00 |
Rulezi on-premise sau la volume mai mari? Discută cu vânzările →
Ascultă vocile, transcrie un apel în consolă sau obține o cheie API și transmite primul tău audio în câteva minute.
