Mihu Voice — наш собственный речевой стек, созданный для живых звонков: Umay превращает речь в текст, пока абонент ещё говорит, а Ses превращает текст в естественную речь на семи языках. Один API с размещением в Европе или Турции либо на ваших собственных серверах.
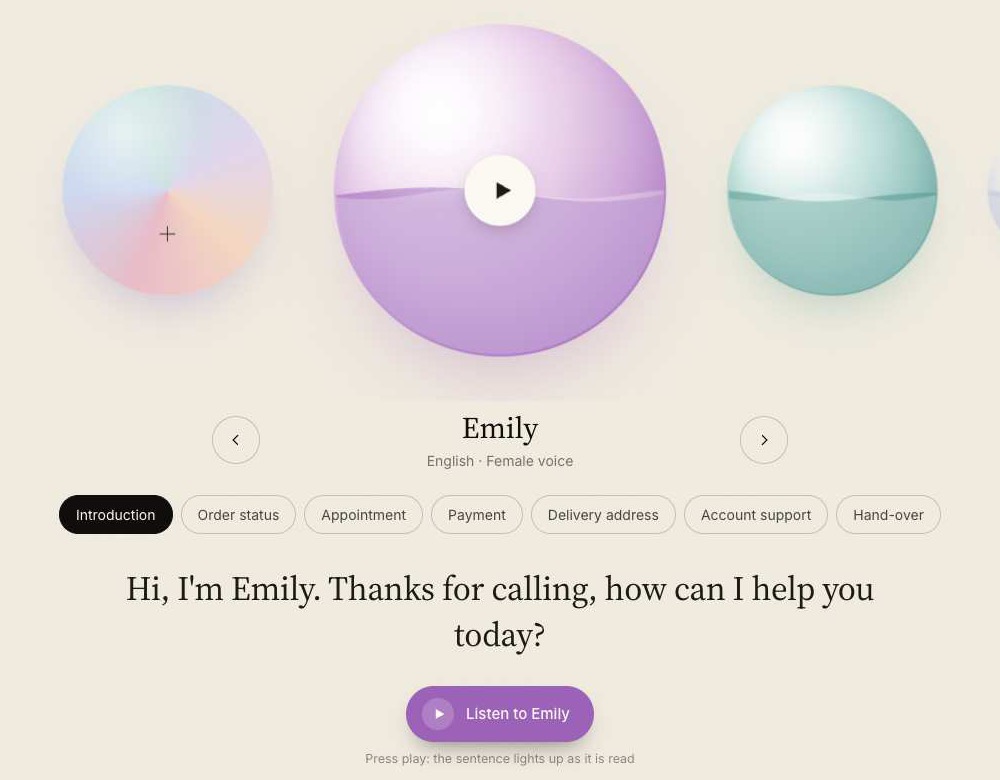
mihu-umay-v1 для распознавания речи и mihu-ses-v1 для синтеза речи доступны по одному API-ключу через REST и WebSocket. Обе модели одинаково отвечают в любом регионе и работают с официальными OpenAI SDK — достаточно сменить базовый URL.
Промежуточный текст поступает по мере того, как человек говорит. Финальное предложение готово примерно через 80 ms после того, как он замолчал, — быстрее, чем моргнуть, поэтому ваш агент может ответить без паузы.
На турецкой читаемой речи доля ошибочных слов у Umay составляет 3.42% — самый низкий показатель среди девяти протестированных нами систем. В режиме только для турецкого один сервер обслуживает до 256 звонков в реальном времени.
Опции для говорящих включаются в каждом запросе отдельно; выключенные, они не добавляют задержки.
model=umaymodel=umay-streamwebhook_urlnormalizehints, hint_contextmode=normalgender_detectiondiarizespeaker_lockvoice_isolationreference_voiceprintPOST /v1/voiceprints/verifyPOST /v1/audio/isolationСуммы, даты и госномера записываются цифрами, это добавляет около 6 ms. Встроенные списки районов и кварталов плюс ваши собственные ключевые слова повышают точность распознавания топонимов в реальном времени на 3–8 пунктов.
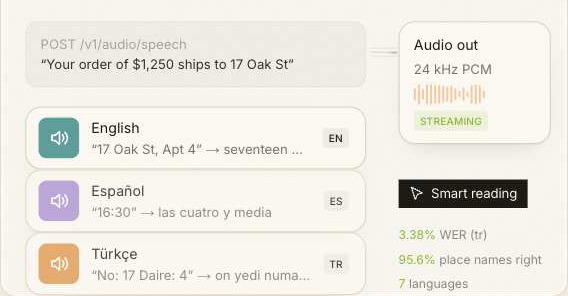
Ses читает адреса, топонимы, суммы, даты, госномера и телефонные номера так, как их произносят люди, на всех семи языках. Аудио начинает поступать ещё до того, как синтезировано всё предложение, и стартует примерно через 0.1 s.
Запишите короткий образец, и Ses создаст собственный голос, который можно использовать наряду с 22 встроенными. Каждый клон проходит проверку чтением и требует согласия говорящего. Запись используется для создания голоса и затем удаляется; сохраняется только сам голос.
Клонировать голос в консолиКаждая система оценивается одинаково на открытых тестовых наборах, с нормализацией чисел и форматов. Чем ниже доля ошибок в словах, тем лучше.
| Язык | Доля ошибок в словах | Точность по словам |
|---|---|---|
| Türkçe | 3.42% | 96.58% |
| English | 6.44% | 93.56% |
| Deutsch | 6.46% | 93.54% |
| Français | 6.70% | 93.30% |
| Español | 3.68% | 96.32% |
| Italiano | 3.34% | 96.66% |
| Русский | 5.61% | 94.39% |
| Язык | Доля ошибок в словах | Точность по словам |
|---|---|---|
| Türkçe | 3.38% | 96.62% |
| English | 1.29% | 98.71% |
| Deutsch | 3.62% | 96.38% |
| Français | 4.41% | 95.59% |
| Español | 2.53% | 97.47% |
| Italiano | 3.36% | 96.64% |
| Русский | 5.04% | 94.96% |
Турецкий также измерен на телефонных звонках и эфирных записях. Методы, все протестированные системы и полные графики — на странице бенчмарков. Все бенчмарки →
Пробуйте голоса, расшифровывайте, клонируйте и управляйте ключами без кода. А как долго что хранится, решаете вы.
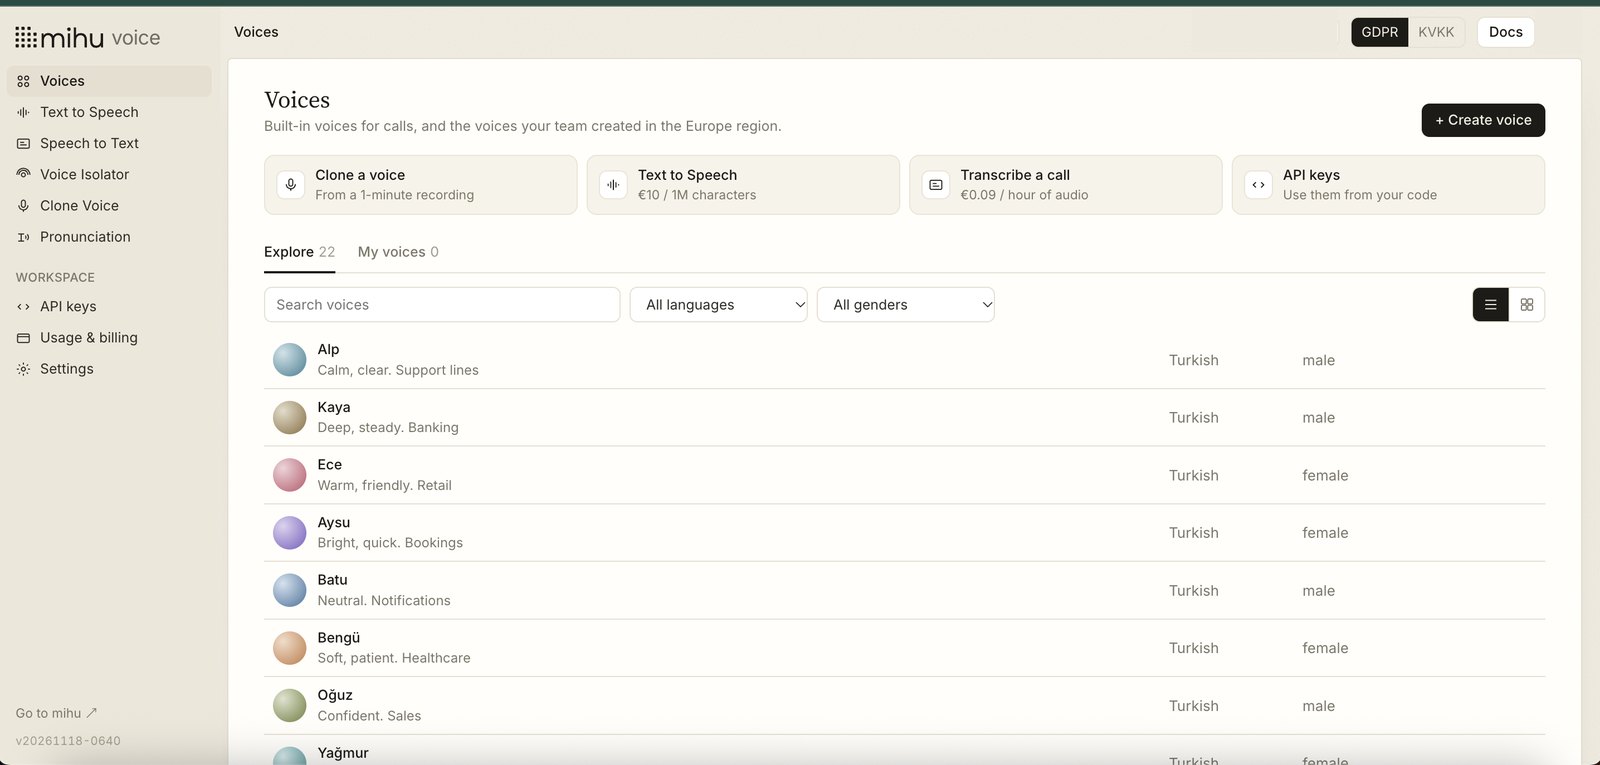
Встроенные голоса и ваши собственные. Прослушайте любой из них перед использованием.
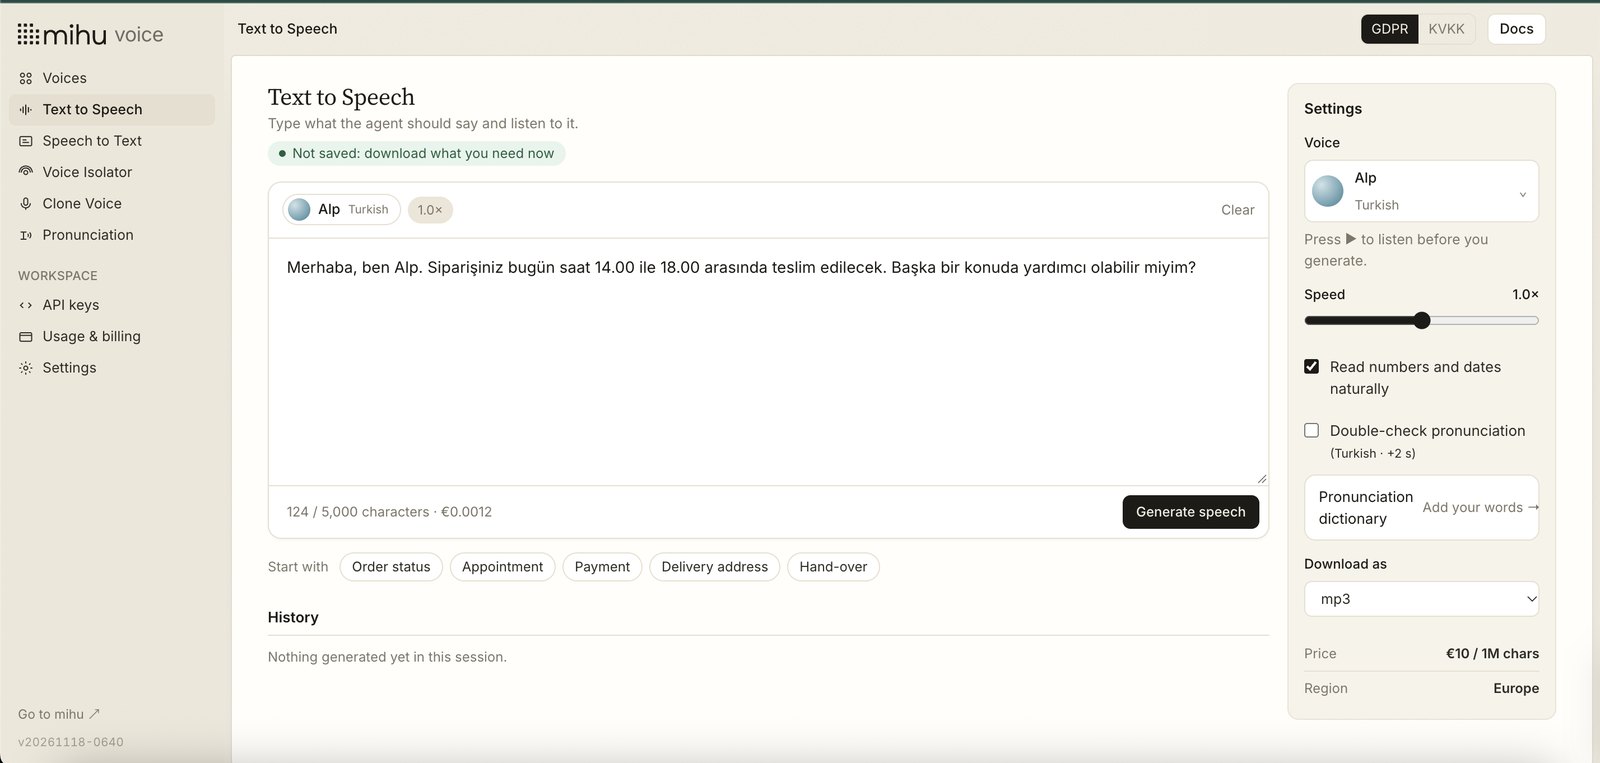
Введите текст, выберите голос и услышьте начало примерно через 0.1 s. Скачивание в mp3, wav, flac и других форматах.
Загрузите файл или ссылку, запишите или включите режим реального времени и смотрите, как слова появляются, пока вы говорите.
Уберите фоновые голоса и шум из записи; сравните до и после.
Голос из 10–30 секунд речи, с проверкой чтением и согласием говорящего.
Ключи для ваших серверов, код быстрого старта для каждого региона и ваши расходы.
Mihu SDK не нужен, и на вашей стороне ничего не запускается. Живые звонки передают аудио через WebSocket; файлы и синтез работают по обычному HTTPS. Выбор региона меняет только хост.
import asyncio, json, websockets

URL = "wss://stt.eu.mihu.ai/v1/stream?model=umay-stream&language=tr&api_key=KEY"

async def transcribe(chunks):  # 100 ms of 16 kHz mono int16 PCM
    async with websockets.connect(URL, max_size=None) as ws:
        async def read():
            async for m in ws:
                d = json.loads(m)
                if d["type"] == "final":
                    print(d["text"])  # send this to your LLM
        reader = asyncio.create_task(read())
        for chunk in chunks:
            await ws.send(chunk)
        await ws.send(json.dumps({"event": "end"}))
await readerЖивые потоки обрабатываются в памяти и никогда не записываются на диск. Файл хранится только на время расшифровки.
Результаты API возвращаются вам и не сохраняются. В консоли вы сами выбираете, сколько хранить расшифровки: от нуля до 3 лет.
Голосовые записи никогда не хранятся. Сохраняется только числовая подпись, и только по вашему запросу; её можно удалить навсегда.
Прейскурантные цены в евро. Опции оплачиваются отдельно и только при использовании. Файлы и живые потоки стоят одинаково.
| Нагрузка | Объём | Стоимость |
|---|---|---|
| Расшифровать 10,000 звонков по 3 минуты | 500 часов аудио | €45.00 |
| Озвучить 10,000 ответов по 200 символов | 2 миллиона символов | €20.00 |
| Расшифровать 1,000 часов записей | 1,000 часов аудио | €90.00 |
| 10,000 звонков по 3 минуты с диаризацией говорящих | 500 часов + 10,000 разговоров | €145.00 |
Работаете on-prem или с большими объёмами? Связаться с отделом продаж →
Послушайте голоса, расшифруйте звонок в консоли или получите API-ключ и отправьте первое аудио за считаные минуты.
