Mihu Voice — наш власний мовленнєвий стек, створений для живих дзвінків: Umay перетворює мовлення на текст, поки абонент ще говорить, а Ses перетворює текст на природне мовлення сімома мовами. Один API з розміщенням у Європі чи Туреччині або на ваших власних серверах.
mihu-umay-v1 для розпізнавання мовлення та mihu-ses-v1 для синтезу мовлення доступні за одним API-ключем через REST і WebSocket. Обидві моделі однаково відповідають у кожному регіоні й працюють з офіційними OpenAI SDK — достатньо змінити базовий URL.
Проміжний текст надходить, поки людина говорить. Фінальне речення готове приблизно через 80 ms після того, як вона замовкла, — швидше, ніж кліпнути оком, тож ваш агент може відповісти без паузи.
На турецькому читаному мовленні частка помилкових слів у Umay становить 3.42% — найнижчий показник серед дев'яти протестованих нами систем. У режимі лише для турецької один сервер обслуговує до 256 дзвінків наживо.
Опції для мовців вмикаються в кожному запиті окремо; вимкнені, вони не додають затримки.
model=umaymodel=umay-streamwebhook_urlnormalizehints, hint_contextmode=normalgender_detectiondiarizespeaker_lockvoice_isolationreference_voiceprintPOST /v1/voiceprints/verifyPOST /v1/audio/isolationСуми, дати й номерні знаки записуються цифрами, що додає близько 6 ms. Вбудовані списки районів і кварталів плюс ваші власні ключові слова підвищують точність розпізнавання назв місць наживо на 3–8 пунктів.
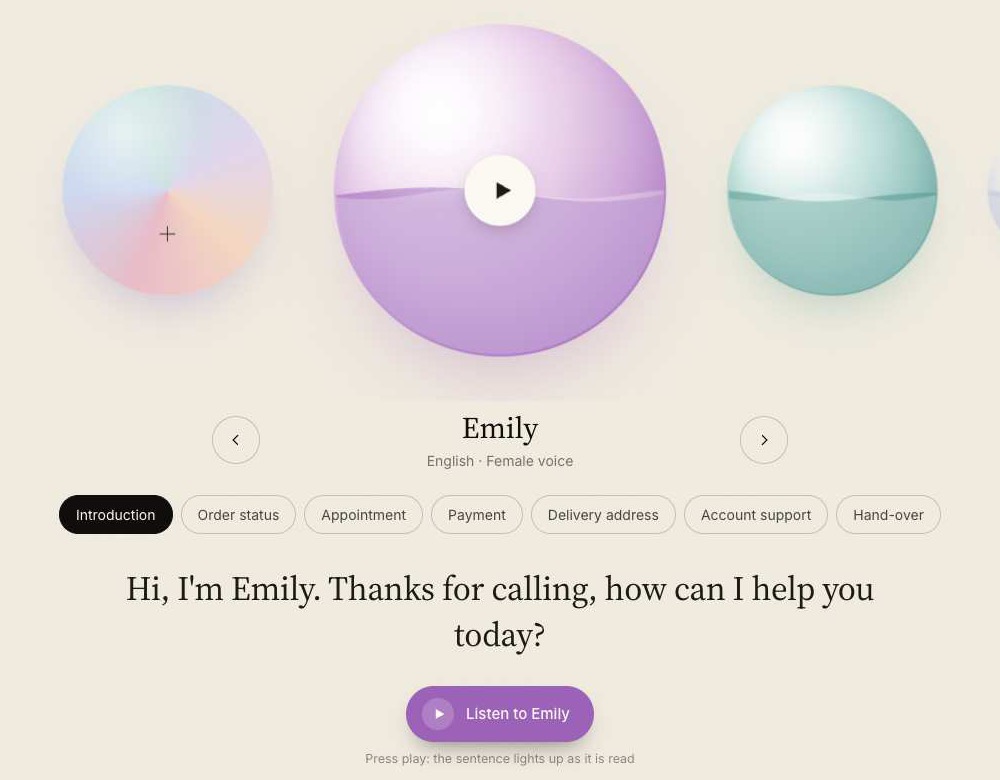
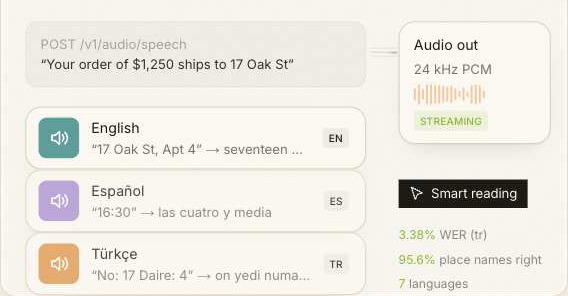
Ses читає адреси, назви місць, суми, дати, номерні знаки й номери телефонів так, як їх вимовляють люди, усіма сімома мовами. Аудіо починає надходити ще до того, як синтезовано все речення, і стартує приблизно за 0.1 s.
Запишіть короткий зразок, і Ses створить власний голос, який можна використовувати поряд із 22 вбудованими. Кожен клон проходить перевірку читанням і потребує згоди мовця. Запис використовується для створення голосу, а потім видаляється; зберігається лише сам голос.
Клонувати голос у консоліКожну систему оцінюють однаково на відкритих тестових наборах, з нормалізацією чисел і форматів. Що нижча частка помилок у словах, то краще.
| Мова | Частка помилок у словах | Точність за словами |
|---|---|---|
| Türkçe | 3.42% | 96.58% |
| English | 6.44% | 93.56% |
| Deutsch | 6.46% | 93.54% |
| Français | 6.70% | 93.30% |
| Español | 3.68% | 96.32% |
| Italiano | 3.34% | 96.66% |
| Русский | 5.61% | 94.39% |
| Мова | Частка помилок у словах | Точність за словами |
|---|---|---|
| Türkçe | 3.38% | 96.62% |
| English | 1.29% | 98.71% |
| Deutsch | 3.62% | 96.38% |
| Français | 4.41% | 95.59% |
| Español | 2.53% | 97.47% |
| Italiano | 3.36% | 96.64% |
| Русский | 5.04% | 94.96% |
Турецьку також виміряно на телефонних дзвінках і ефірних записах. Методи, усі протестовані системи та повні графіки — на сторінці бенчмарків. Усі бенчмарки →
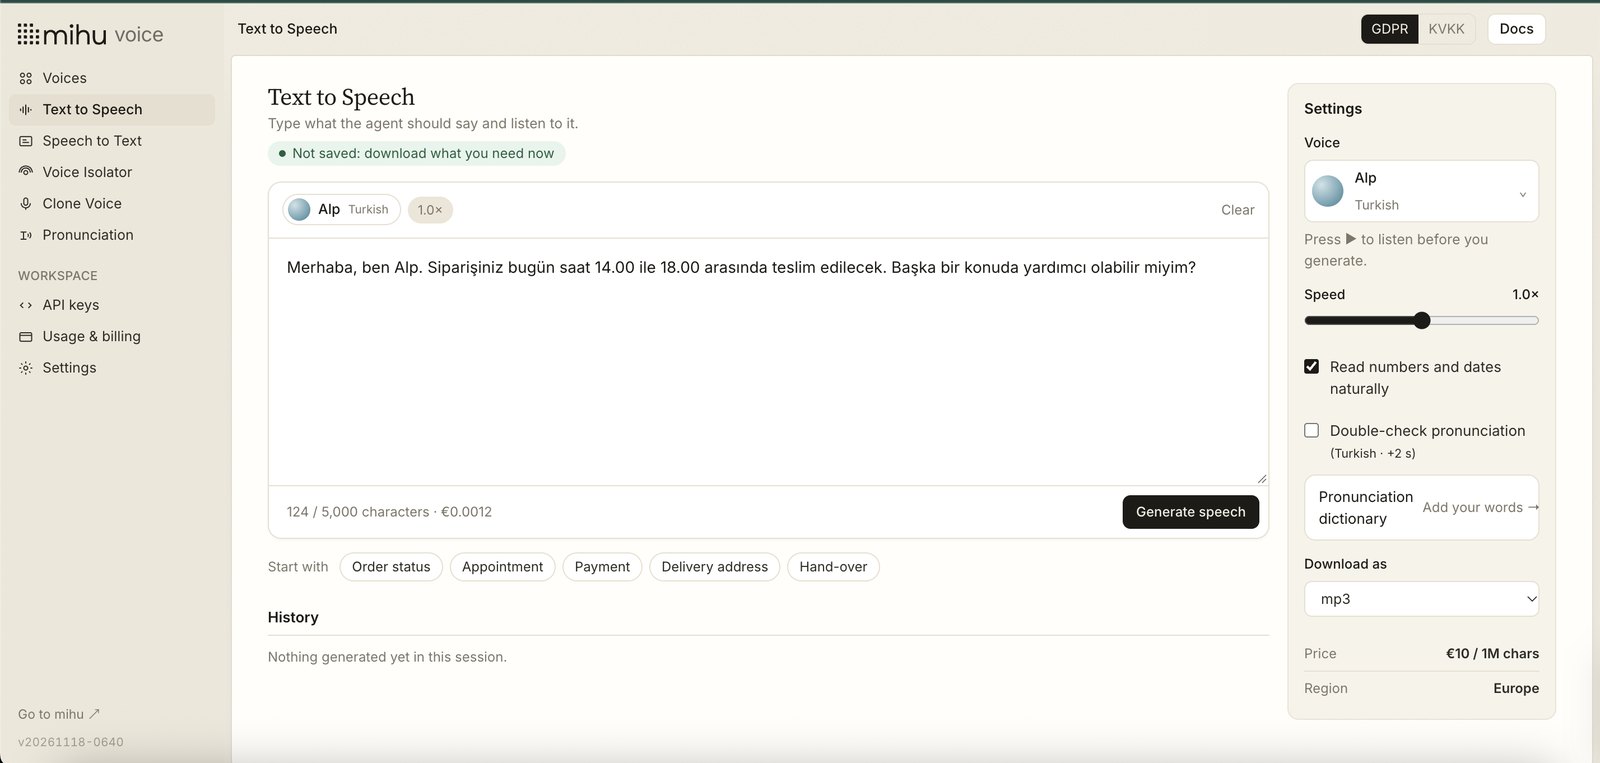
Пробуйте голоси, транскрибуйте, клонуйте та керуйте ключами без коду. А скільки що зберігається, вирішуєте ви.
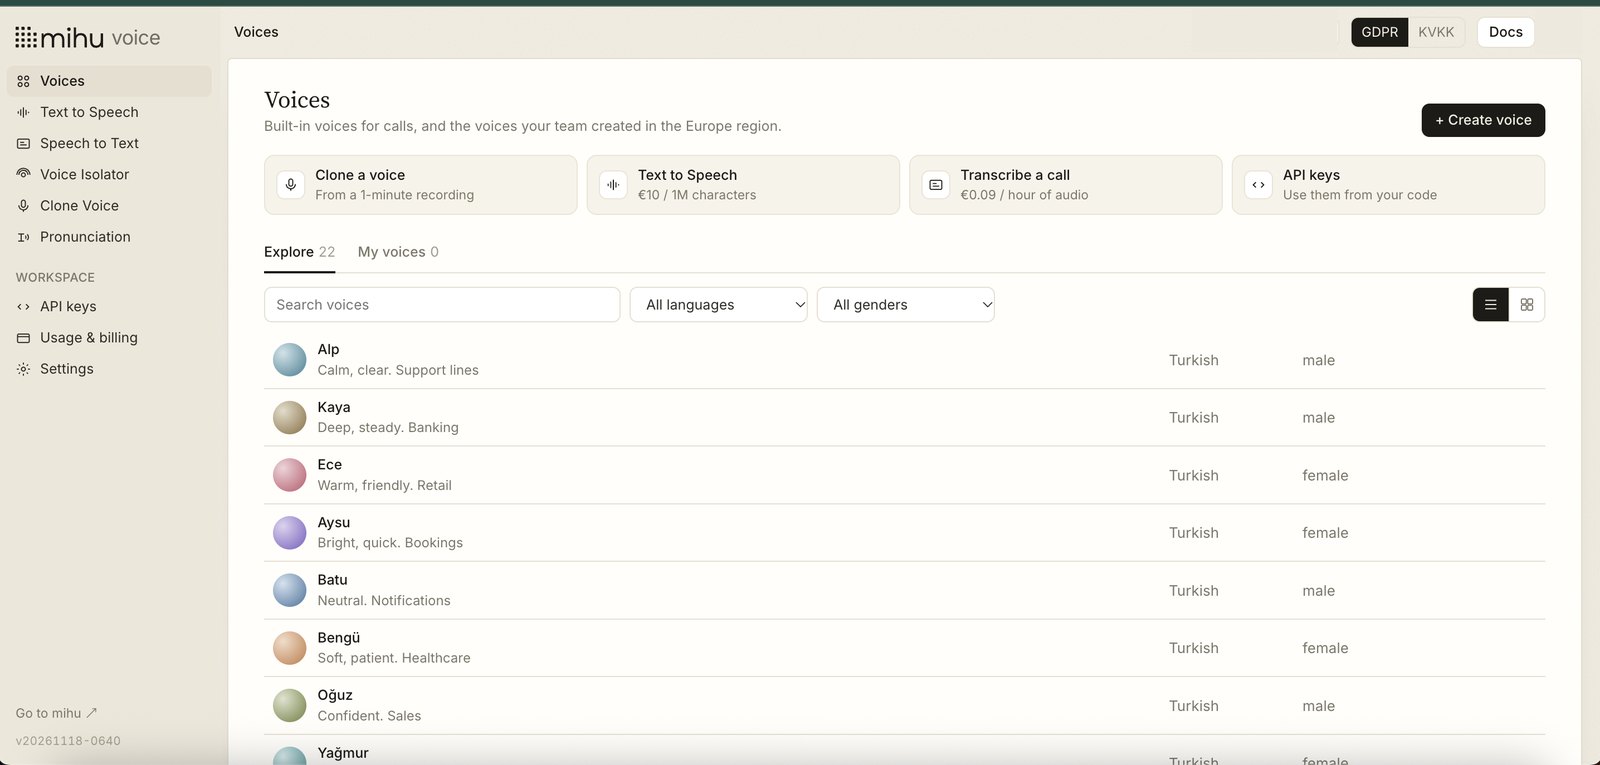
Вбудовані голоси та ваші власні. Прослухайте будь-який перед використанням.
Введіть текст, виберіть голос і почуйте початок приблизно за 0.1 s. Завантаження в mp3, wav, flac та інших форматах.
Завантажте файл або посилання, запишіть чи увімкніть режим наживо й дивіться, як слова з'являються, поки ви говорите.
Приберіть фонові голоси та шум із запису; порівняйте до і після.
Голос із 10–30 секунд мовлення, з перевіркою читанням і згодою мовця.
Ключі для ваших серверів, код швидкого старту для кожного регіону та ваші витрати.
Mihu SDK не потрібен, і на вашому боці нічого не запускається. Живі дзвінки передають аудіо через WebSocket; файли та синтез працюють через звичайний HTTPS. Вибір регіону змінює лише хост.
import asyncio, json, websockets

URL = "wss://stt.eu.mihu.ai/v1/stream?model=umay-stream&language=tr&api_key=KEY"

async def transcribe(chunks):  # 100 ms of 16 kHz mono int16 PCM
    async with websockets.connect(URL, max_size=None) as ws:
        async def read():
            async for m in ws:
                d = json.loads(m)
                if d["type"] == "final":
                    print(d["text"])  # send this to your LLM
        reader = asyncio.create_task(read())
        for chunk in chunks:
            await ws.send(chunk)
        await ws.send(json.dumps({"event": "end"}))
await readerЖиві потоки обробляються в пам'яті й ніколи не записуються на диск. Файл зберігається лише на час транскрипції.
Результати API повертаються вам і не зберігаються. У консолі ви самі обираєте, скільки зберігати транскрипції: від нуля до 3 років.
Голосові записи ніколи не зберігаються. Зберігається лише числовий підпис, і лише на ваш запит; його можна видалити назавжди.
Прейскурантні ціни в євро. Опції оплачуються окремо й лише тоді, коли ви їх використовуєте. Файли та живі потоки коштують однаково.
| Навантаження | Обсяг | Вартість |
|---|---|---|
| Транскрибувати 10,000 дзвінків по 3 хвилини | 500 годин аудіо | €45.00 |
| Озвучити 10,000 відповідей по 200 символів | 2 мільйони символів | €20.00 |
| Транскрибувати 1,000 годин записів | 1,000 годин аудіо | €90.00 |
| 10,000 дзвінків по 3 хвилини з діаризацією мовців | 500 годин + 10,000 розмов | €145.00 |
Працюєте on-prem або з більшими обсягами? Зв'язатися з відділом продажів →
Послухайте голоси, транскрибуйте дзвінок у консолі або отримайте API-ключ і надішліть перше аудіо за лічені хвилини.
