Mihu Voice es nuestra propia pila de voz, creada para llamadas en directo: Umay convierte la voz en texto mientras el interlocutor aún está hablando, y Ses convierte el texto en voz natural en siete idiomas. Una sola API, alojada en Europa o Turquía, o en sus propios servidores.
mihu-umay-v1 para voz a texto y mihu-ses-v1 para texto a voz funcionan con una sola clave API, mediante REST y WebSocket. Ambos responden igual en todas las regiones y funcionan con los SDK oficiales de OpenAI cambiando solo la URL base.
El texto parcial llega en streaming mientras la persona habla. La frase final está lista unos 80 ms después de que deje de hablar, más rápido que un parpadeo, para que su agente responda sin pausas.
En voz leída en turco, Umay tiene una tasa de error de palabras del 3.42%, la más baja de los nueve sistemas que probamos. En modo solo turco, un servidor gestiona hasta 256 llamadas en directo.
Las opciones de hablante se activan por solicitud; desactivadas no añaden latencia.
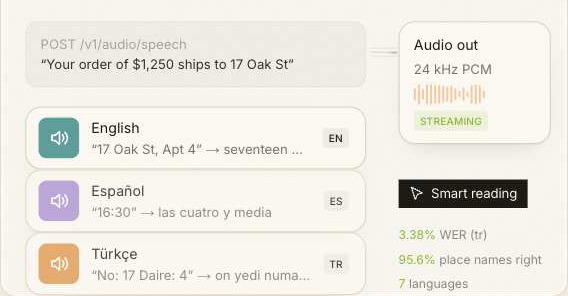
model=umaymodel=umay-streamwebhook_urlnormalizehints, hint_contextmode=normalgender_detectiondiarizespeaker_lockvoice_isolationreference_voiceprintPOST /v1/voiceprints/verifyPOST /v1/audio/isolationImportes, fechas y matrículas se escriben como números, con solo unos 6 ms adicionales. Las listas integradas de distritos y barrios, junto con sus propias palabras clave, mejoran entre 3 y 8 puntos la precisión de los nombres de lugares en directo.
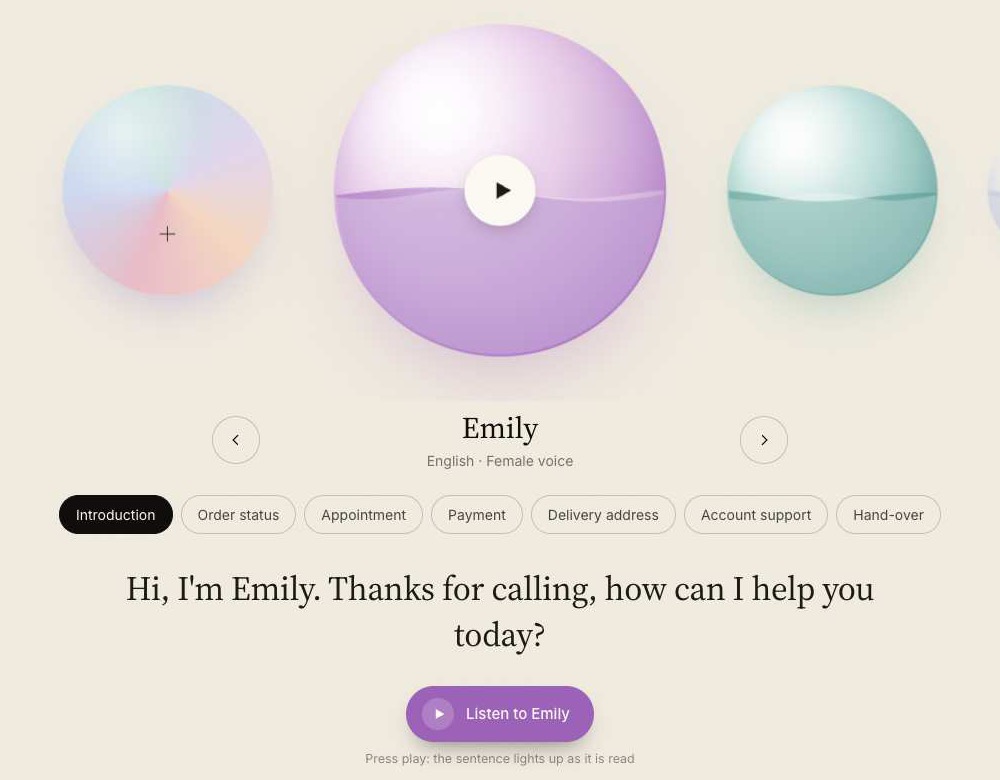
Ses lee direcciones, nombres de lugares, importes, fechas, matrículas y números de teléfono como los dice la gente, en los siete idiomas. El audio llega en streaming antes de que se sintetice la frase completa y empieza en unos 0.1 s.
Grabe una muestra breve y Ses crea una voz personalizada que puede usar junto a las 22 integradas. Cada clon pasa una comprobación de lectura y requiere el consentimiento del hablante. La grabación se usa para crear la voz y después se descarta; solo se conserva la voz.
Clonar una voz en la consolaCada sistema se evalúa igual en conjuntos de prueba públicos, con números y formatos normalizados. Una tasa de error de palabras más baja es mejor.
| Idioma | Tasa de error de palabras | Precisión de palabras |
|---|---|---|
| Türkçe | 3.42% | 96.58% |
| English | 6.44% | 93.56% |
| Deutsch | 6.46% | 93.54% |
| Français | 6.70% | 93.30% |
| Español | 3.68% | 96.32% |
| Italiano | 3.34% | 96.66% |
| Русский | 5.61% | 94.39% |
| Idioma | Tasa de error de palabras | Precisión de palabras |
|---|---|---|
| Türkçe | 3.38% | 96.62% |
| English | 1.29% | 98.71% |
| Deutsch | 3.62% | 96.38% |
| Français | 4.41% | 95.59% |
| Español | 2.53% | 97.47% |
| Italiano | 3.36% | 96.64% |
| Русский | 5.04% | 94.96% |
El turco también se mide en llamadas telefónicas y medios de difusión. Los métodos, todos los sistemas probados y los gráficos completos están en la página de benchmarks. Todos los benchmarks →
Pruebe voces, transcriba, clone y gestione claves sin escribir código. Y usted decide cuánto tiempo se conserva cada cosa.
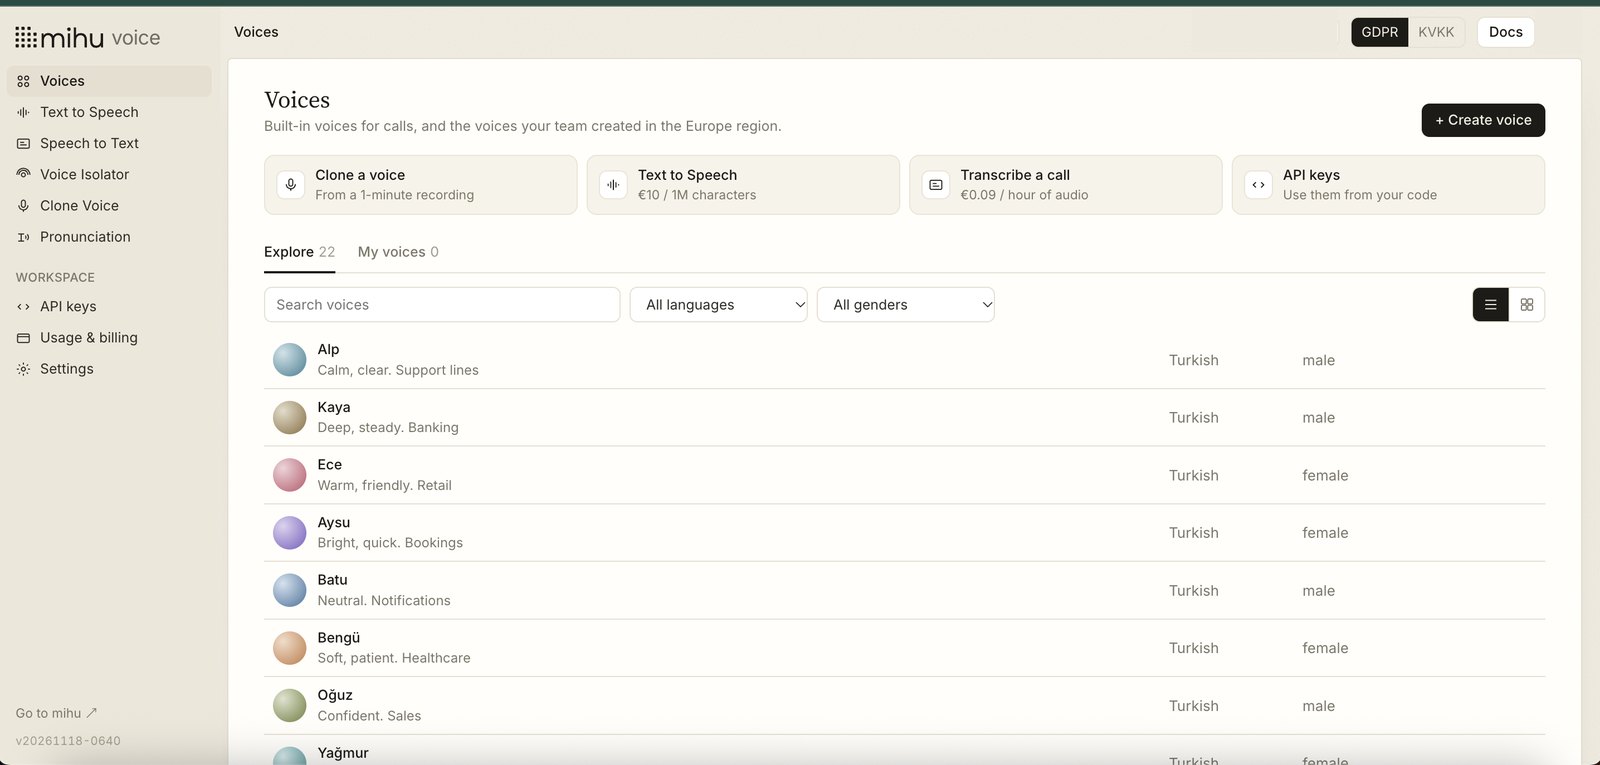
Las voces integradas y las suyas. Escuche cualquiera antes de usarla.
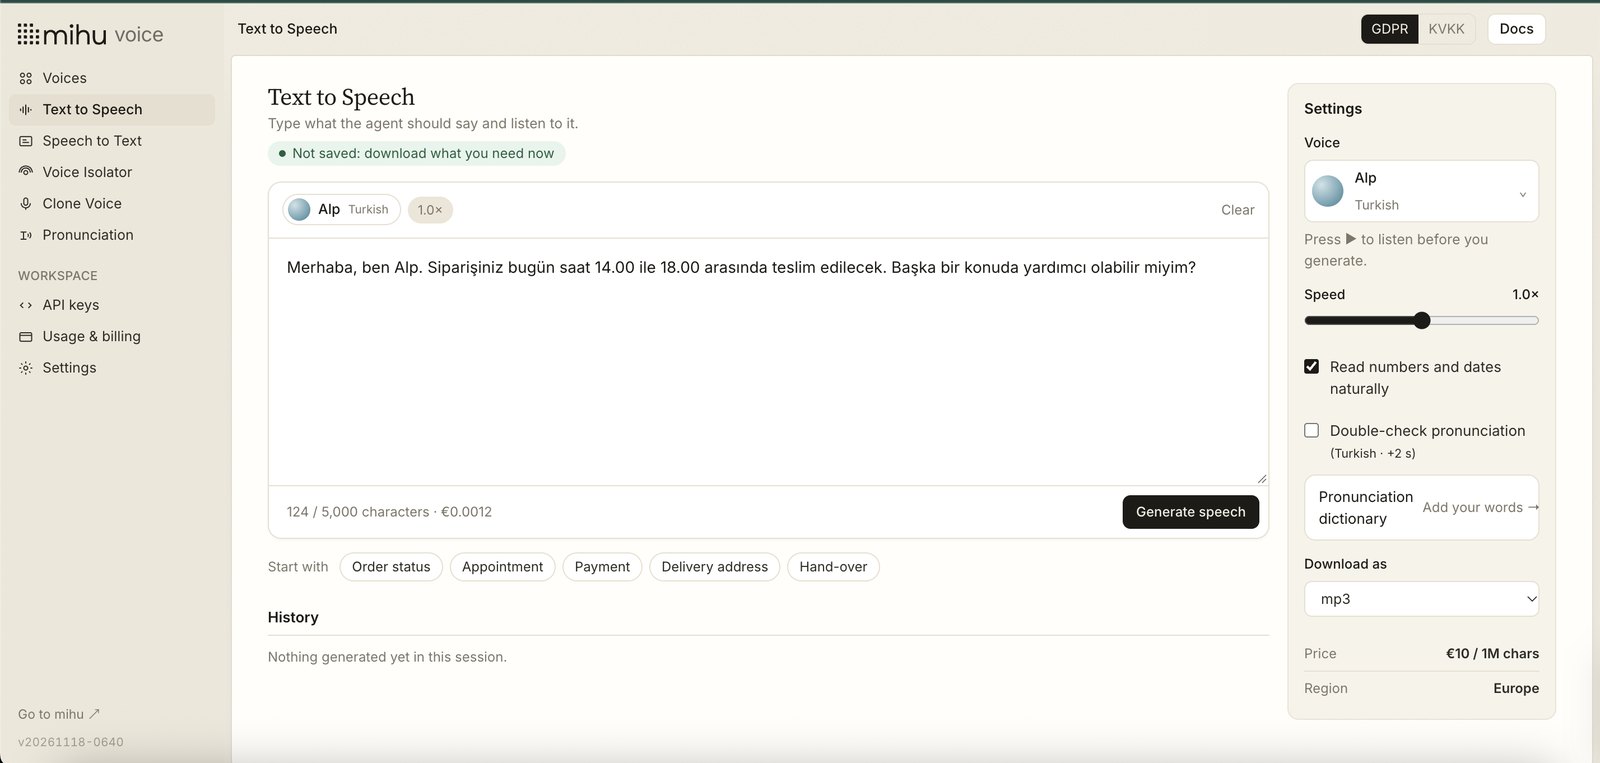
Escriba, elija una voz y escúchela empezar en unos 0.1 s. Descargue en mp3, wav, flac y más.
Suba un archivo o un enlace, grabe o pase a directo y vea aparecer las palabras mientras habla.
Elimine voces de fondo y ruido de una grabación; compare el antes y el después.
Una voz a partir de 10–30 segundos de habla, con comprobación de lectura y consentimiento del hablante.
Claves para sus servidores, código de inicio rápido por región y lo que lleva gastado.
No necesita ningún SDK de Mihu y no se ejecuta nada de su lado. Las llamadas en directo transmiten audio por un WebSocket; los archivos y la síntesis usan HTTPS estándar. Elegir una región solo cambia el host.
import asyncio, json, websockets

URL = "wss://stt.eu.mihu.ai/v1/stream?model=umay-stream&language=tr&api_key=KEY"

async def transcribe(chunks):  # 100 ms of 16 kHz mono int16 PCM
    async with websockets.connect(URL, max_size=None) as ws:
        async def read():
            async for m in ws:
                d = json.loads(m)
                if d["type"] == "final":
                    print(d["text"])  # send this to your LLM
        reader = asyncio.create_task(read())
        for chunk in chunks:
            await ws.send(chunk)
        await ws.send(json.dumps({"event": "end"}))
await readerLos streams en directo se procesan en memoria y nunca se escriben en disco. Un archivo solo se conserva mientras se transcribe.
Los resultados de la API se le devuelven, no se guardan. En la consola usted elige cuánto tiempo se conservan las transcripciones, desde nada hasta 3 años.
Las grabaciones de voz nunca se almacenan. Solo se guarda una firma numérica, y solo si usted lo solicita; se puede eliminar de forma definitiva.
Precios de lista en euros. Las opciones se facturan aparte, solo cuando las usa. Archivos y streams en directo cuestan lo mismo.
| Carga de trabajo | Volumen | Coste |
|---|---|---|
| Transcribir 10,000 llamadas de 3 minutos | 500 horas de audio | €45.00 |
| Pronunciar 10,000 respuestas de 200 caracteres | 2 millones de caracteres | €20.00 |
| Transcribir 1,000 horas de grabaciones | 1,000 horas de audio | €90.00 |
| 10,000 llamadas de 3 minutos con diarización de hablantes | 500 horas + 10,000 conversaciones | €145.00 |
¿On-premise o mayor volumen? Hablar con Ventas →
Escuche las voces, transcriba una llamada en la consola u obtenga una clave API y transmita su primer audio en minutos.
