Mihu Voice is onze eigen spraakstack, gebouwd voor live gesprekken: Umay zet spraak om in tekst terwijl de beller nog praat, en Ses maakt van tekst natuurlijke spraak in zeven talen. Eén API, gehost in Europa of Turkije, of op uw eigen servers.
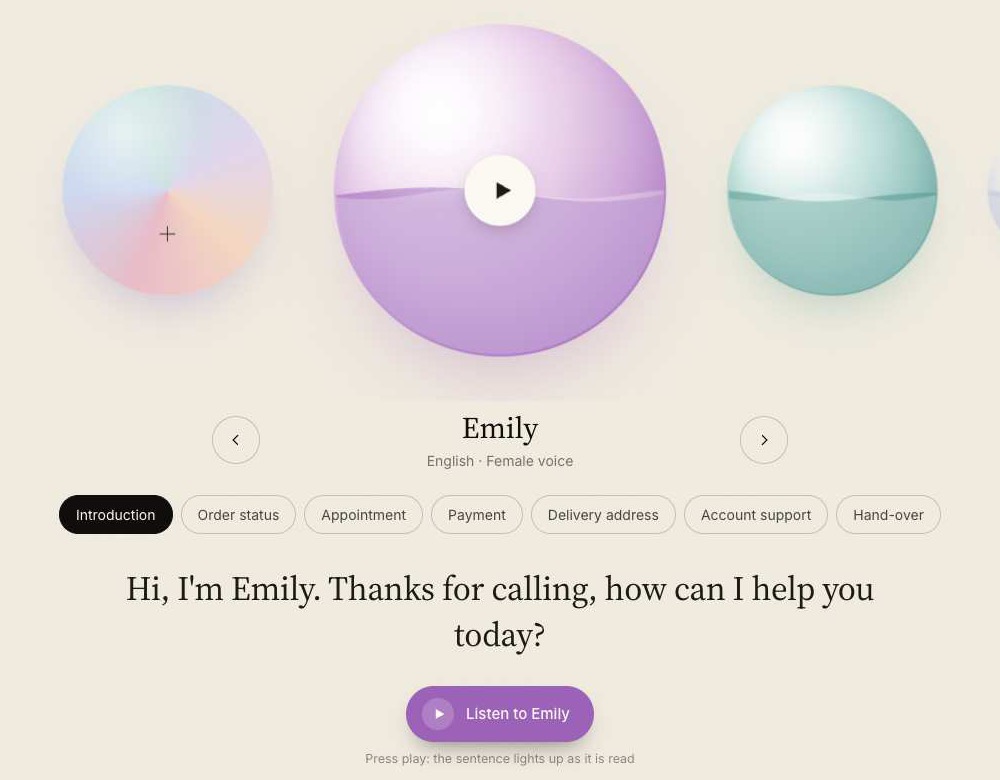
mihu-umay-v1 voor spraak naar tekst en mihu-ses-v1 voor tekst naar spraak zitten achter één API-sleutel, via REST en WebSocket. Beide reageren in elke regio op dezelfde manier en werken met de officiële OpenAI-SDK's door alleen de base-URL te wijzigen.
Gedeeltelijke tekst streamt binnen terwijl iemand praat. De definitieve zin staat ongeveer 80 ms na het stoppen klaar, sneller dan een knipoog, zodat uw agent zonder pauze kan antwoorden.
Op Turkse voorgelezen spraak haalt Umay een woordfoutpercentage van 3.42%, het laagste van de negen systemen die we testten. In de modus alleen Turks verwerkt één server tot 256 live gesprekken.
Sprekeropties worden per request ingeschakeld; uit betekent geen extra latentie.
model=umaymodel=umay-streamwebhook_urlnormalizehints, hint_contextmode=normalgender_detectiondiarizespeaker_lockvoice_isolationreference_voiceprintPOST /v1/voiceprints/verifyPOST /v1/audio/isolationBedragen, datums en kentekens worden als cijfers geschreven, wat ongeveer 6 ms extra kost. Ingebouwde lijsten van districten en wijken plus uw eigen hotwords verhogen de nauwkeurigheid van plaatsnamen in live gesprekken met 3 tot 8 punten.
Ses leest adressen, plaatsnamen, bedragen, datums, kentekens en telefoonnummers zoals mensen ze uitspreken, in alle zeven talen. De audio streamt terug voordat de hele zin is gesynthetiseerd en begint na ongeveer 0.1 s.
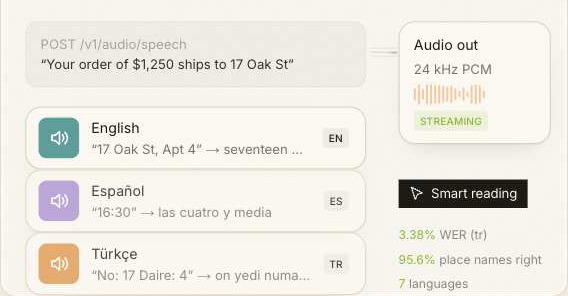
Neem een kort fragment op en Ses bouwt een eigen stem die u naast de 22 ingebouwde stemmen kunt gebruiken. Elke kloon doorloopt een leescontrole en vereist toestemming van de spreker. De opname wordt gebruikt om de stem te bouwen en daarna verwijderd; alleen de stem zelf blijft bewaard.
Kloon een stem in de consoleElk systeem wordt op dezelfde manier beoordeeld op openbare testsets, met genormaliseerde getallen en formaten. Een lager woordfoutpercentage is beter.
| Taal | Woordfoutpercentage | Woordnauwkeurigheid |
|---|---|---|
| Türkçe | 3.42% | 96.58% |
| English | 6.44% | 93.56% |
| Deutsch | 6.46% | 93.54% |
| Français | 6.70% | 93.30% |
| Español | 3.68% | 96.32% |
| Italiano | 3.34% | 96.66% |
| Русский | 5.61% | 94.39% |
| Taal | Woordfoutpercentage | Woordnauwkeurigheid |
|---|---|---|
| Türkçe | 3.38% | 96.62% |
| English | 1.29% | 98.71% |
| Deutsch | 3.62% | 96.38% |
| Français | 4.41% | 95.59% |
| Español | 2.53% | 97.47% |
| Italiano | 3.36% | 96.64% |
| Русский | 5.04% | 94.96% |
Turks wordt ook gemeten op telefoongesprekken en uitzendingen. Methoden, alle geteste systemen en de volledige grafieken staan op de benchmarkpagina. Alle benchmarks →
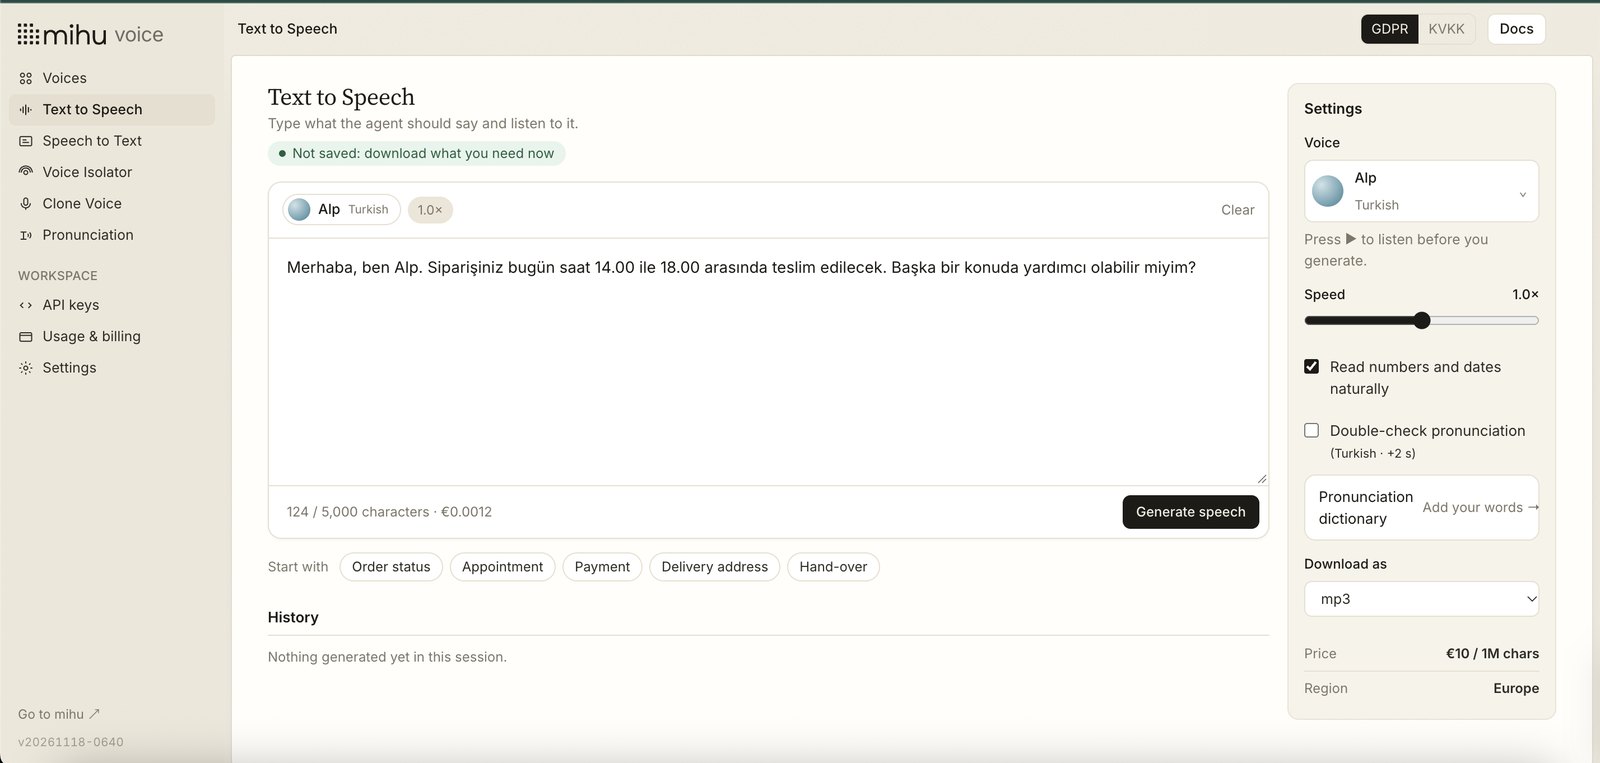
Probeer stemmen, transcribeer, kloon en beheer sleutels zonder code te schrijven. En u bepaalt hoe lang iets bewaard blijft.
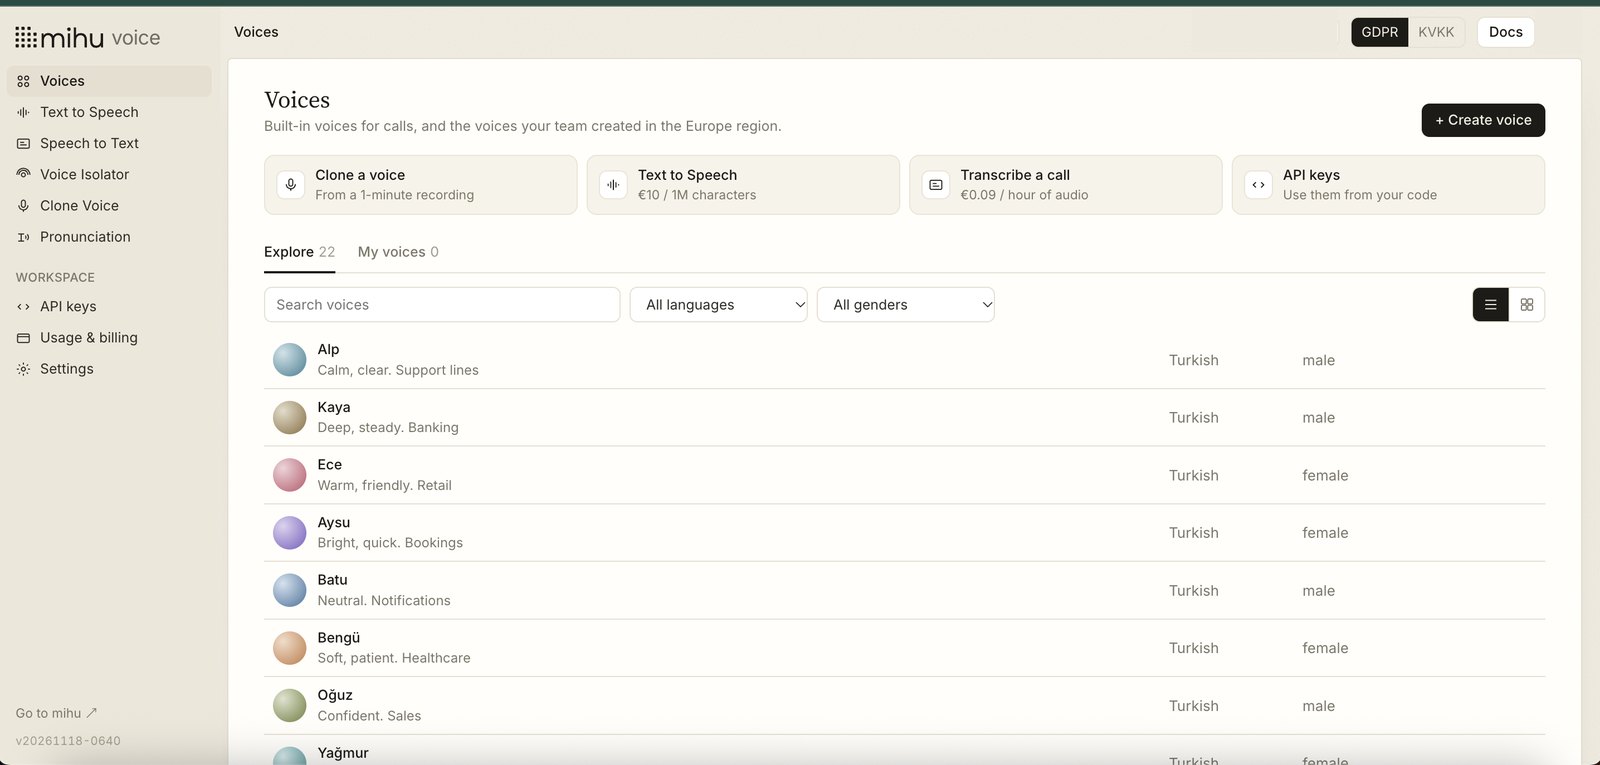
De ingebouwde stemmen en uw eigen stemmen. Beluister ze voordat u ze gebruikt.
Typ, kies een stem en hoor hem na ongeveer 0.1 s beginnen. Download als mp3, wav, flac en meer.
Upload een bestand of link, neem op, of ga live en zie de woorden verschijnen terwijl u praat.
Verwijder achtergrondstemmen en ruis uit een opname; vergelijk voor en na.
Een stem uit 10–30 seconden spraak, met leescontrole en toestemming van de spreker.
Sleutels voor uw servers, quick-startcode per regio en wat u hebt uitgegeven.
Er is geen Mihu-SDK nodig en er draait niets aan uw kant. Live gesprekken streamen audio via een WebSocket; bestanden en synthese gebruiken gewoon HTTPS. Een regio kiezen verandert alleen de host.
import asyncio, json, websockets

URL = "wss://stt.eu.mihu.ai/v1/stream?model=umay-stream&language=tr&api_key=KEY"

async def transcribe(chunks):  # 100 ms of 16 kHz mono int16 PCM
    async with websockets.connect(URL, max_size=None) as ws:
        async def read():
            async for m in ws:
                d = json.loads(m)
                if d["type"] == "final":
                    print(d["text"])  # send this to your LLM
        reader = asyncio.create_task(read())
        for chunk in chunks:
            await ws.send(chunk)
        await ws.send(json.dumps({"event": "end"}))
await readerLive streams worden in het geheugen verwerkt en nooit naar schijf geschreven. Een bestand wordt alleen bewaard zolang het wordt getranscribeerd.
API-resultaten worden aan u teruggegeven, niet bewaard. In de console kiest u hoe lang transcripties blijven, van helemaal niet tot 3 jaar.
Stemopnames worden nooit opgeslagen. Alleen een numerieke handtekening wordt bewaard, en alleen als u daarom vraagt; die kan definitief worden verwijderd.
Catalogusprijzen in euro. Opties worden apart gefactureerd, alleen als u ze gebruikt. Bestanden en live streams kosten hetzelfde.
| Workload | Volume | Kosten |
|---|---|---|
| 10,000 gesprekken van 3 minuten transcriberen | 500 uur audio | €45.00 |
| 10,000 antwoorden van 200 tekens uitspreken | 2 miljoen tekens | €20.00 |
| 1,000 uur opnames transcriberen | 1,000 uur audio | €90.00 |
| 10,000 gesprekken van 3 minuten met sprekerdiarisatie | 500 uur + 10,000 gesprekken | €145.00 |
On-premise of op grotere schaal? Praat met sales →
Beluister de stemmen, transcribeer een gesprek in de console, of haal een API-sleutel op en stream binnen enkele minuten uw eerste audio.
