O Mihu Voice é o nosso próprio stack de voz, feito para chamadas ao vivo: o Umay transforma fala em texto enquanto quem liga ainda está falando, e o Ses transforma texto em fala natural em sete idiomas. Uma API, hospedada na Europa ou na Turquia, ou nos seus próprios servidores.
O mihu-umay-v1 para fala para texto e o mihu-ses-v1 para texto para fala ficam atrás de uma única chave de API, via REST e WebSocket. Os dois respondem da mesma forma em todas as regiões e funcionam com os SDKs oficiais da OpenAI, bastando trocar a base URL.
O texto parcial chega em streaming enquanto a pessoa fala. A frase final fica pronta cerca de 80 ms depois que ela para, mais rápido que um piscar de olhos, então seu agente responde sem pausa.
Em fala lida em turco, o Umay tem taxa de erro de palavras de 3.42%, a menor entre os nove sistemas que testamos. No modo só turco, um servidor atende até 256 chamadas ao vivo.
As opções de falante são ativadas por requisição; desativadas, não adicionam latência.
model=umaymodel=umay-streamwebhook_urlnormalizehints, hint_contextmode=normalgender_detectiondiarizespeaker_lockvoice_isolationreference_voiceprintPOST /v1/voiceprints/verifyPOST /v1/audio/isolationValores, datas e placas são escritos como números, com cerca de 6 ms a mais. Listas integradas de distritos e bairros, mais suas próprias hotwords, aumentam a precisão de nomes de lugares ao vivo em 3 a 8 pontos.
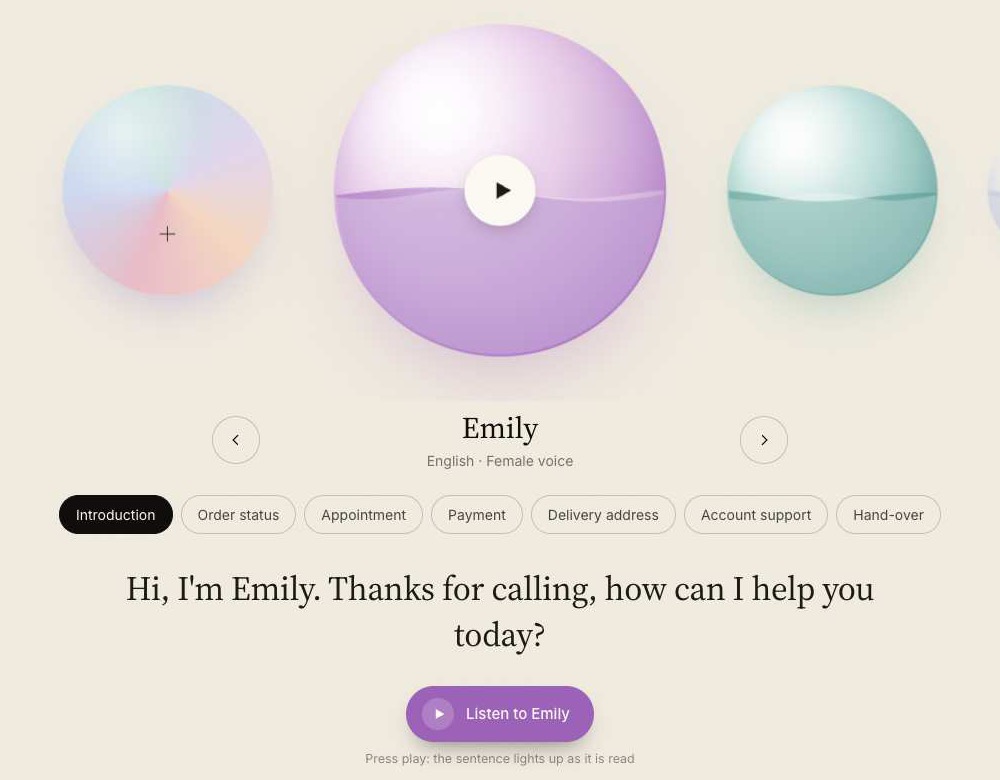
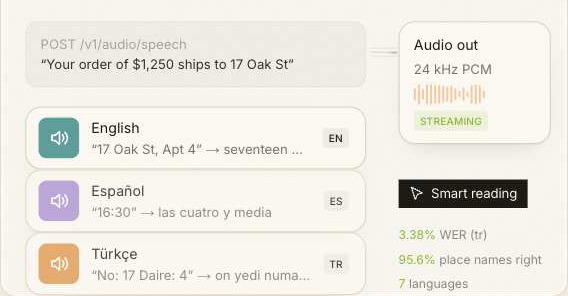
O Ses lê endereços, nomes de lugares, valores, datas, placas e telefones do jeito que as pessoas falam, nos sete idiomas. O áudio volta em streaming antes de a frase inteira ser sintetizada e começa em cerca de 0.1 s.
Grave uma amostra curta e o Ses cria uma voz personalizada que você pode usar ao lado das 22 vozes prontas. Cada clone passa por uma checagem de leitura e exige o consentimento de quem fala. A gravação é usada para criar a voz e depois descartada; só a voz é mantida.
Clonar uma voz no consoleCada sistema é avaliado da mesma forma em conjuntos de teste públicos, com números e formatos normalizados. Taxa de erro de palavras menor é melhor.
| Idioma | Taxa de erro de palavras | Precisão de palavras |
|---|---|---|
| Türkçe | 3.42% | 96.58% |
| English | 6.44% | 93.56% |
| Deutsch | 6.46% | 93.54% |
| Français | 6.70% | 93.30% |
| Español | 3.68% | 96.32% |
| Italiano | 3.34% | 96.66% |
| Русский | 5.61% | 94.39% |
| Idioma | Taxa de erro de palavras | Precisão de palavras |
|---|---|---|
| Türkçe | 3.38% | 96.62% |
| English | 1.29% | 98.71% |
| Deutsch | 3.62% | 96.38% |
| Français | 4.41% | 95.59% |
| Español | 2.53% | 97.47% |
| Italiano | 3.36% | 96.64% |
| Русский | 5.04% | 94.96% |
O turco também é medido em chamadas telefônicas e mídia de transmissão. Métodos, todos os sistemas testados e os gráficos completos estão na página de benchmarks. Todos os benchmarks →
Teste vozes, transcreva, clone e gerencie chaves sem escrever código. E você decide por quanto tempo cada coisa fica guardada.
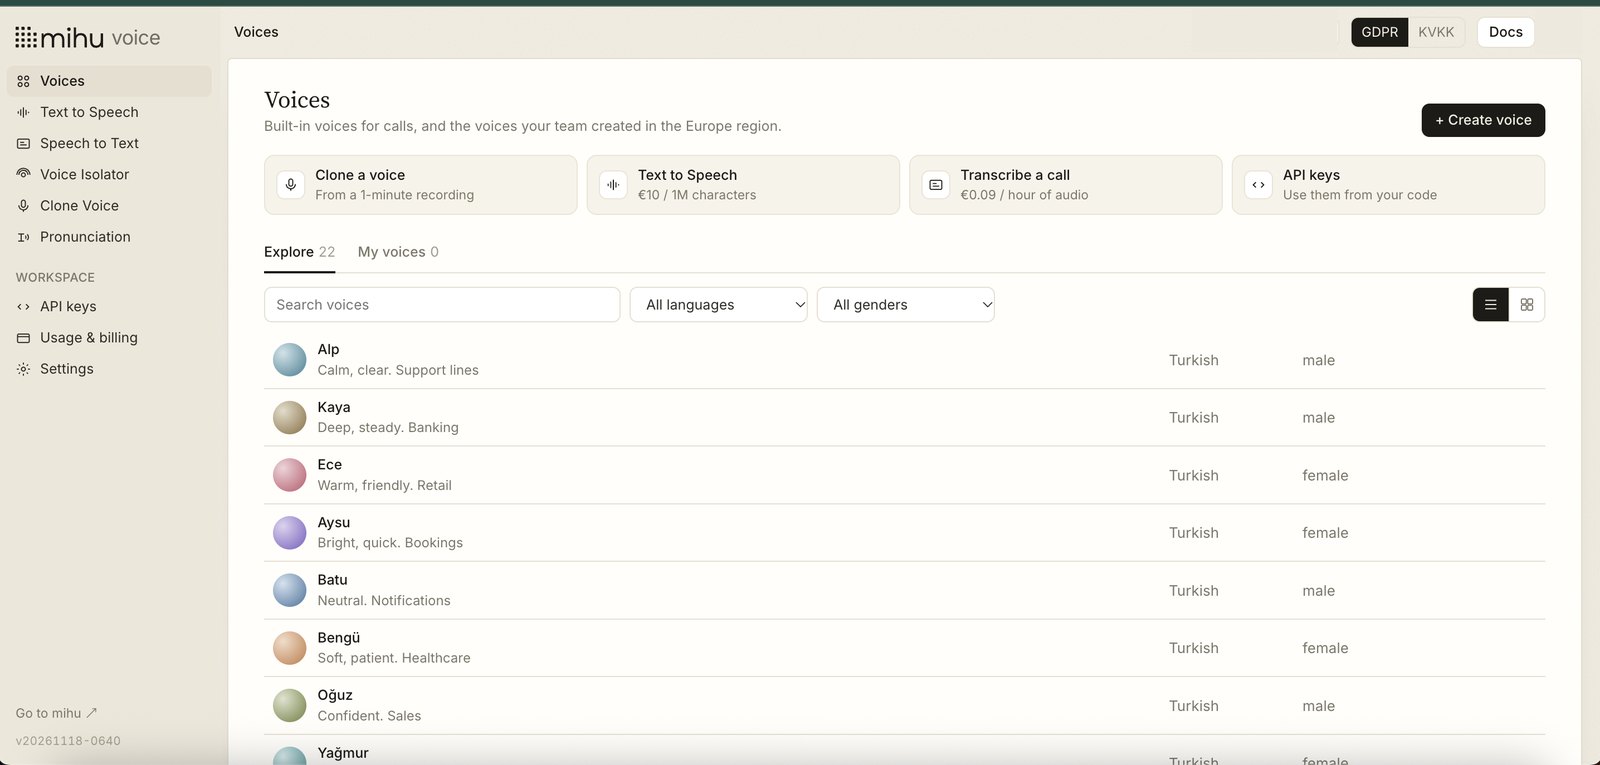
As vozes prontas e as suas. Ouça qualquer uma antes de usar.
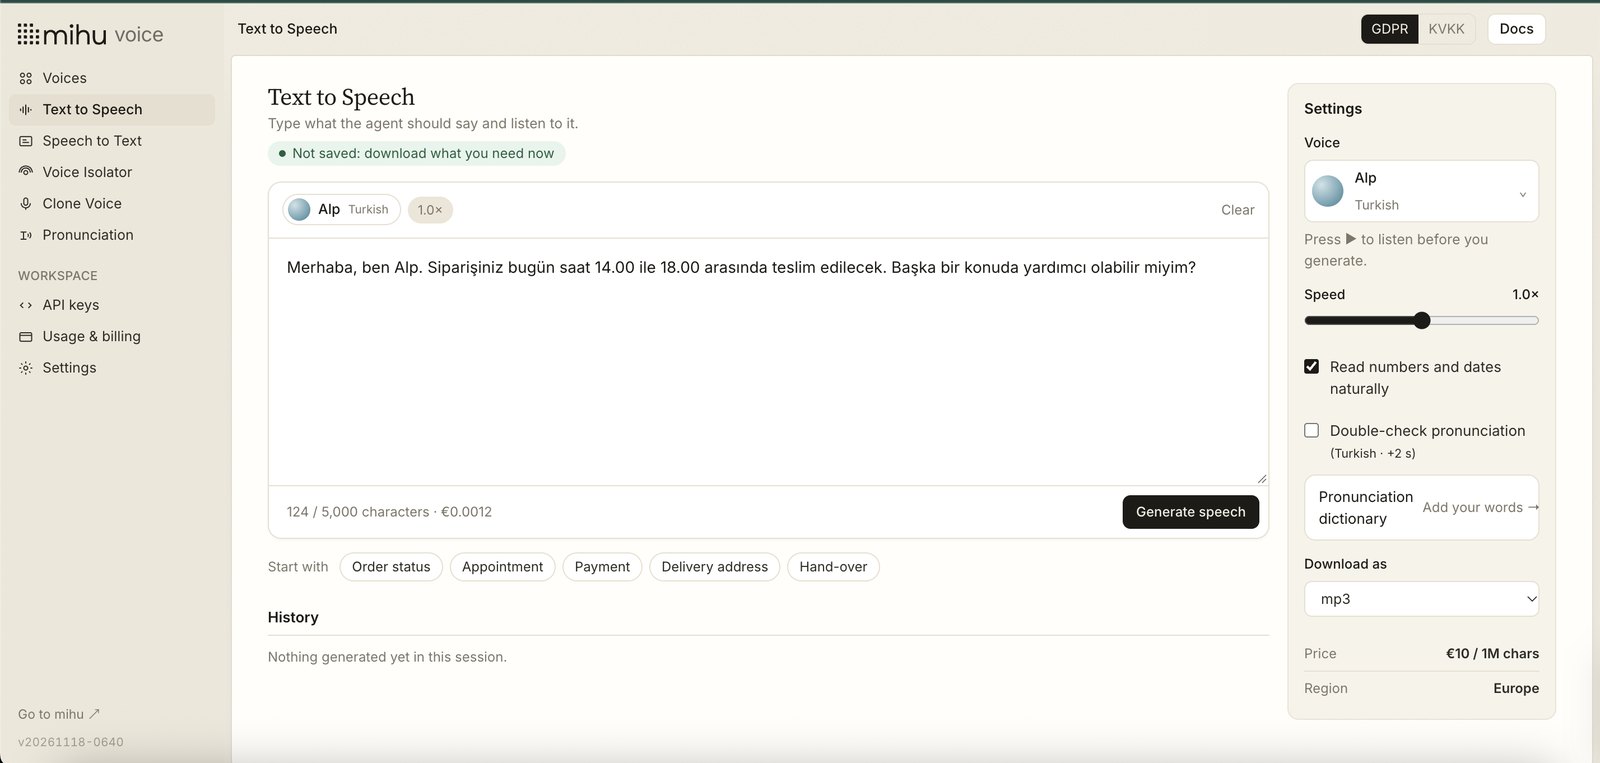
Digite, escolha uma voz e ouça começar em cerca de 0.1 s. Baixe em mp3, wav, flac e mais.
Envie um arquivo ou um link, grave, ou entre ao vivo e veja as palavras aparecerem enquanto você fala.
Remova vozes de fundo e ruído de uma gravação; compare antes e depois.
Uma voz a partir de 10–30 segundos de fala, com checagem de leitura e consentimento de quem fala.
Chaves para os seus servidores, código de início rápido por região e quanto você gastou.
Nenhum SDK da Mihu é necessário e nada roda do seu lado. Chamadas ao vivo transmitem áudio via WebSocket; arquivos e síntese usam HTTPS simples. Escolher uma região muda apenas o host.
import asyncio, json, websockets

URL = "wss://stt.eu.mihu.ai/v1/stream?model=umay-stream&language=tr&api_key=KEY"

async def transcribe(chunks):  # 100 ms of 16 kHz mono int16 PCM
    async with websockets.connect(URL, max_size=None) as ws:
        async def read():
            async for m in ws:
                d = json.loads(m)
                if d["type"] == "final":
                    print(d["text"])  # send this to your LLM
        reader = asyncio.create_task(read())
        for chunk in chunks:
            await ws.send(chunk)
        await ws.send(json.dumps({"event": "end"}))
await readerStreams ao vivo são processados em memória e nunca gravados em disco. Um arquivo só é mantido enquanto é transcrito.
Os resultados da API são devolvidos a você, não guardados. No console, você escolhe por quanto tempo as transcrições ficam, de nada até 3 anos.
Gravações de voz nunca são armazenadas. Só uma assinatura numérica é mantida, e apenas se você pedir; ela pode ser apagada de vez.
Preços de tabela em euros. As opções são cobradas à parte, só quando você as usa. Arquivos e streams ao vivo custam o mesmo.
| Carga de trabalho | Volume | Custo |
|---|---|---|
| Transcrever 10,000 chamadas de 3 minutos | 500 horas de áudio | €45.00 |
| Falar 10,000 respostas de 200 caracteres | 2 milhões de caracteres | €20.00 |
| Transcrever 1,000 horas de gravações | 1,000 horas de áudio | €90.00 |
| 10,000 chamadas de 3 minutos com diarização de falantes | 500 horas + 10,000 conversas | €145.00 |
Vai rodar on-premise ou em volume maior? Falar com vendas →
Ouça as vozes, transcreva uma chamada no console ou obtenha uma chave de API e transmita seu primeiro áudio em minutos.
