Mihu Voice est notre propre pile vocale, conçue pour les appels en direct : Umay transforme la parole en texte pendant que l'appelant parle encore, et Ses transforme le texte en parole naturelle dans sept langues. Une seule API, hébergée en Europe ou en Turquie, ou sur vos propres serveurs.
mihu-umay-v1 pour la reconnaissance vocale et mihu-ses-v1 pour la synthèse vocale sont accessibles avec une seule clé API, via REST et WebSocket. Les deux répondent de la même façon dans chaque région et fonctionnent avec les SDK officiels d'OpenAI en changeant simplement l'URL de base.
Le texte partiel arrive en continu pendant que la personne parle. La phrase finale est prête environ 80 ms après qu'elle s'arrête, plus vite qu'un clignement d'œil, pour que votre agent réponde sans pause.
Sur la parole lue en turc, Umay atteint un taux d'erreur de mots de 3.42%, le plus bas des neuf systèmes que nous avons testés. En mode turc uniquement, un serveur gère jusqu'à 256 appels en direct.
Les options de locuteur s'activent par requête ; désactivées, elles n'ajoutent aucune latence.
model=umaymodel=umay-streamwebhook_urlnormalizehints, hint_contextmode=normalgender_detectiondiarizespeaker_lockvoice_isolationreference_voiceprintPOST /v1/voiceprints/verifyPOST /v1/audio/isolationLes montants, dates et plaques d'immatriculation sont écrits en chiffres, pour environ 6 ms de plus. Des listes intégrées de districts et de quartiers, plus vos propres mots-clés, améliorent de 3 à 8 points la précision des noms de lieux en direct.
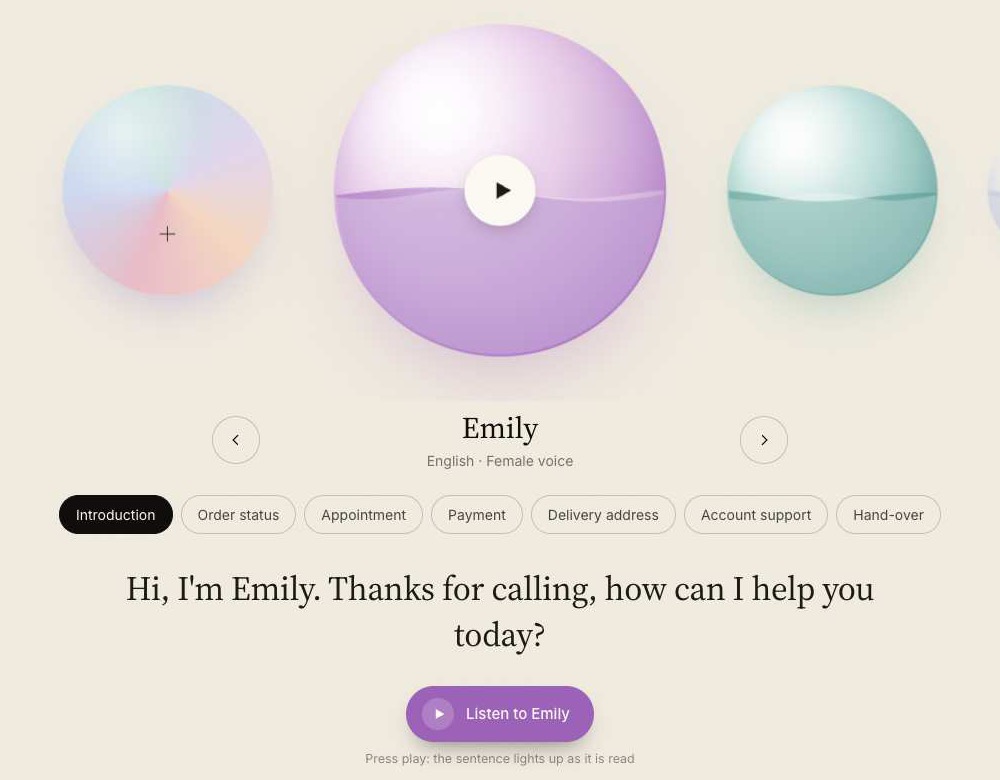
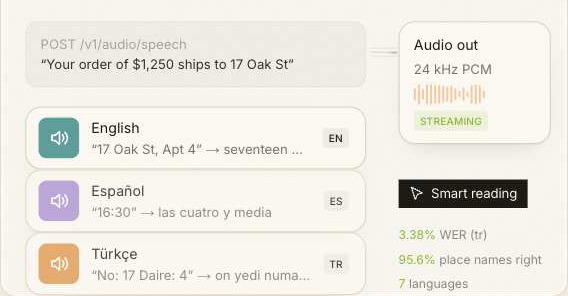
Ses lit les adresses, noms de lieux, montants, dates, plaques et numéros de téléphone comme les gens les prononcent, dans les sept langues. L'audio est diffusé avant que la phrase entière soit synthétisée et démarre en 0.1 s environ.
Enregistrez un court échantillon et Ses crée une voix personnalisée, utilisable à côté des 22 voix intégrées. Chaque clone passe par une vérification de lecture et nécessite le consentement du locuteur. L'enregistrement sert à créer la voix puis est supprimé ; seule la voix elle-même est conservée.
Cloner une voix dans la consoleChaque système est évalué de la même façon sur des jeux de test publics, nombres et formats normalisés. Un taux d’erreur de mots plus bas est meilleur.
| Langue | Taux d’erreur de mots | Précision des mots |
|---|---|---|
| Türkçe | 3.42% | 96.58% |
| English | 6.44% | 93.56% |
| Deutsch | 6.46% | 93.54% |
| Français | 6.70% | 93.30% |
| Español | 3.68% | 96.32% |
| Italiano | 3.34% | 96.66% |
| Русский | 5.61% | 94.39% |
| Langue | Taux d’erreur de mots | Précision des mots |
|---|---|---|
| Türkçe | 3.38% | 96.62% |
| English | 1.29% | 98.71% |
| Deutsch | 3.62% | 96.38% |
| Français | 4.41% | 95.59% |
| Español | 2.53% | 97.47% |
| Italiano | 3.36% | 96.64% |
| Русский | 5.04% | 94.96% |
Le turc est aussi mesuré sur des appels téléphoniques et des médias diffusés. Méthodes, systèmes testés et graphiques complets sur la page des benchmarks. Tous les benchmarks →
Essayez les voix, transcrivez, clonez et gérez vos clés sans écrire de code. Et c'est vous qui décidez combien de temps les données sont conservées.
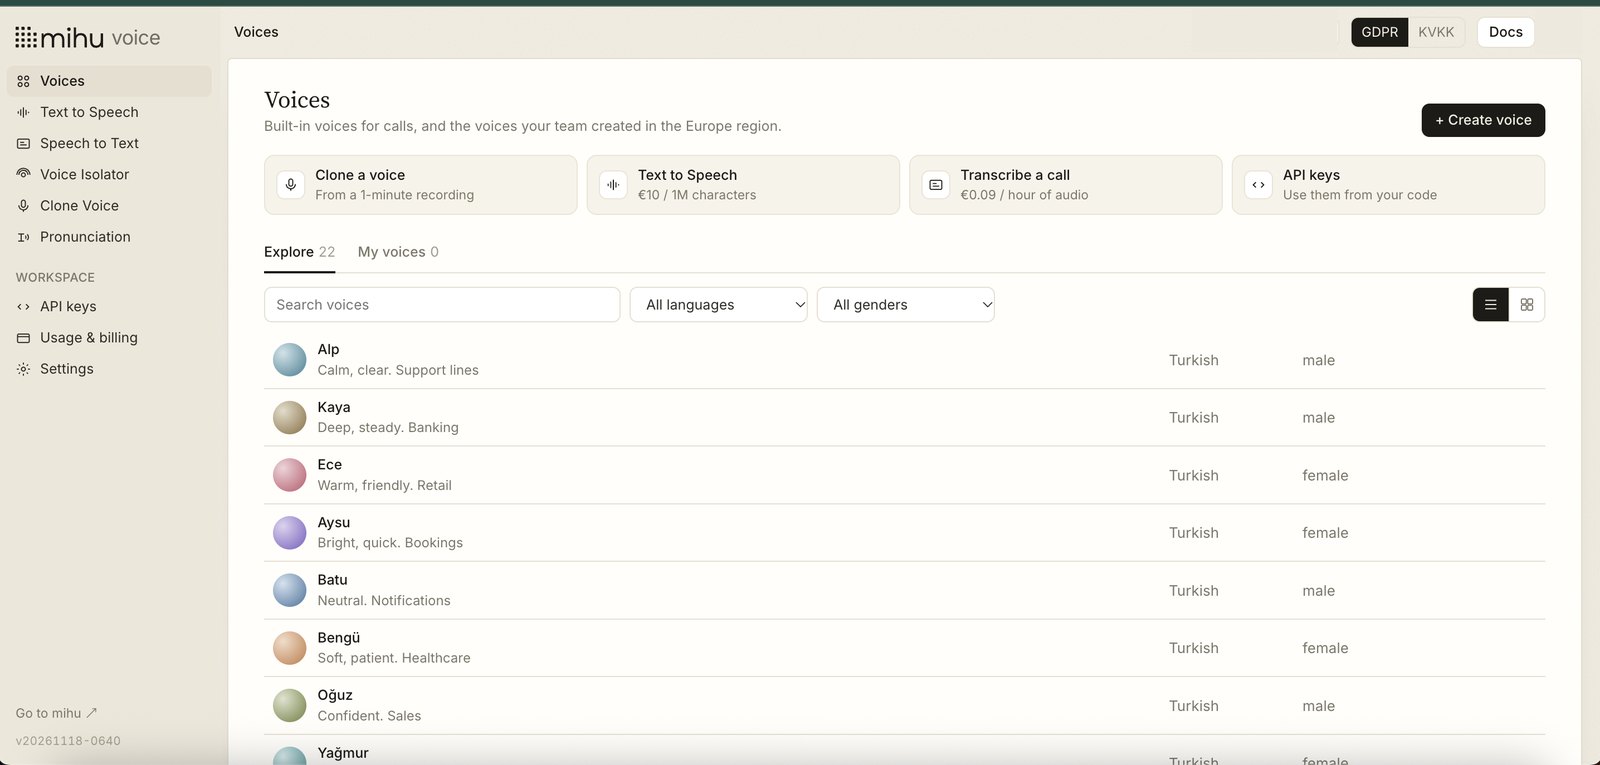
Les voix intégrées et les vôtres. Écoutez chacune avant de l'utiliser.
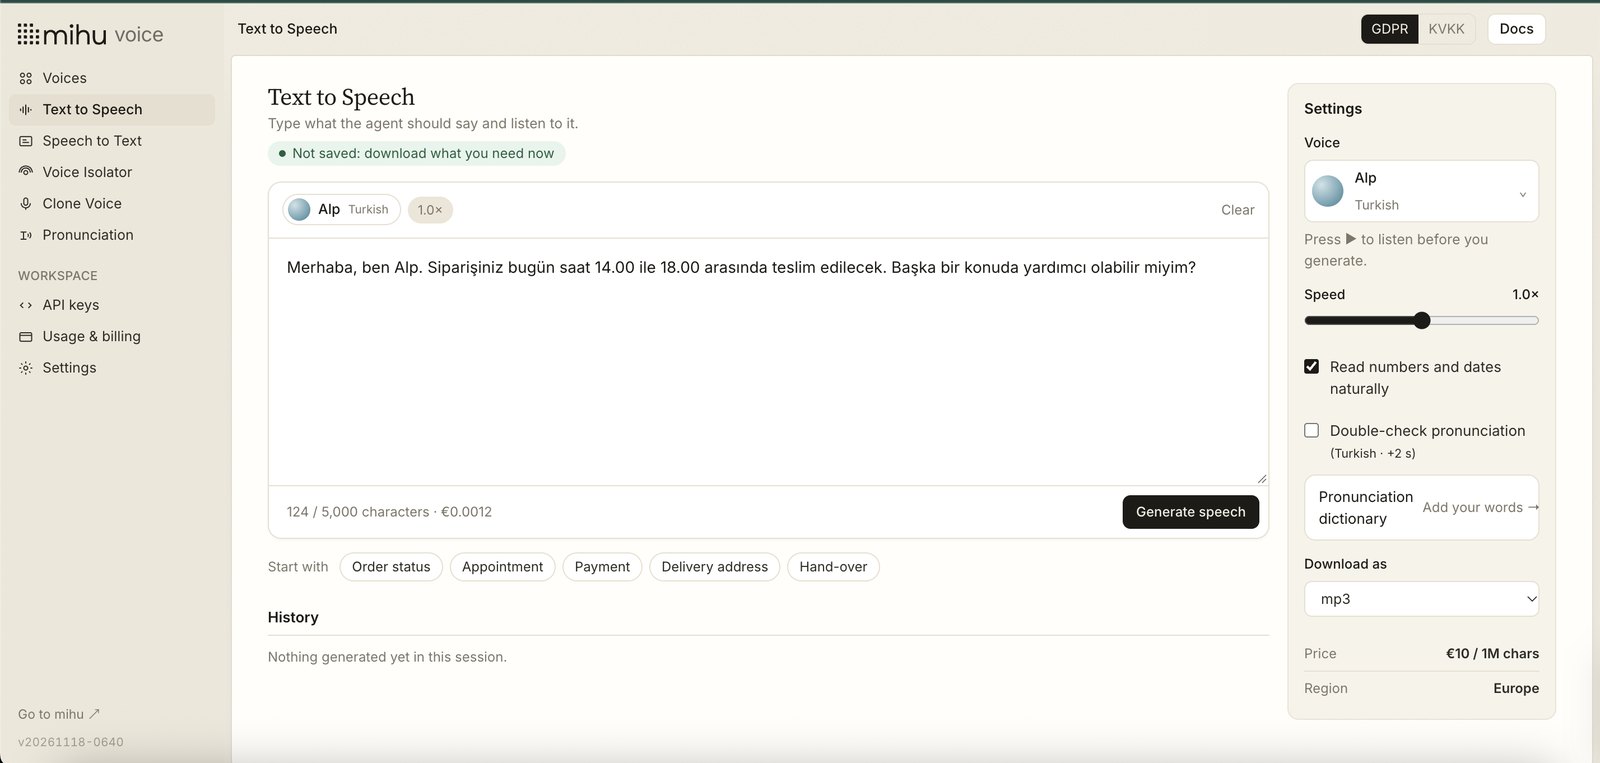
Saisissez, choisissez une voix et entendez-la démarrer en 0.1 s environ. Téléchargement en mp3, wav, flac et plus.
Importez un fichier ou un lien, enregistrez, ou passez en direct et voyez les mots apparaître pendant que vous parlez.
Supprimez les voix de fond et le bruit d'un enregistrement ; comparez avant et après.
Une voix à partir de 10–30 secondes de parole, avec vérification de lecture et consentement du locuteur.
Des clés pour vos serveurs, du code de démarrage rapide par région et vos dépenses.
Aucun SDK Mihu n'est requis et rien ne s'exécute de votre côté. Les appels en direct envoient l'audio via un WebSocket ; les fichiers et la synthèse utilisent simplement HTTPS. Choisir une région ne change que l'hôte.
import asyncio, json, websockets

URL = "wss://stt.eu.mihu.ai/v1/stream?model=umay-stream&language=tr&api_key=KEY"

async def transcribe(chunks):  # 100 ms of 16 kHz mono int16 PCM
    async with websockets.connect(URL, max_size=None) as ws:
        async def read():
            async for m in ws:
                d = json.loads(m)
                if d["type"] == "final":
                    print(d["text"])  # send this to your LLM
        reader = asyncio.create_task(read())
        for chunk in chunks:
            await ws.send(chunk)
        await ws.send(json.dumps({"event": "end"}))
await readerLes flux en direct sont traités en mémoire et jamais écrits sur disque. Un fichier n'est conservé que le temps de sa transcription.
Les résultats de l'API vous sont renvoyés, pas conservés. Dans la console, vous choisissez la durée de conservation des transcriptions, de aucune à 3 ans.
Les enregistrements vocaux ne sont jamais stockés. Seule une signature numérique est conservée, et uniquement si vous le demandez ; elle peut être supprimée définitivement.
Prix catalogue en euros. Les options sont facturées séparément, uniquement si vous les utilisez. Fichiers et flux en direct coûtent le même prix.
| Charge de travail | Volume | Coût |
|---|---|---|
| Transcrire 10,000 appels de 3 minutes | 500 heures d'audio | €45.00 |
| Faire prononcer 10,000 réponses de 200 caractères | 2 millions de caractères | €20.00 |
| Transcrire 1,000 heures d'enregistrements | 1,000 heures d'audio | €90.00 |
| 10,000 appels de 3 minutes avec diarisation des locuteurs | 500 heures + 10,000 conversations | €145.00 |
Déploiement on-premise ou volumes plus importants ? Contacter le service commercial →
Écoutez les voix, transcrivez un appel dans la console, ou obtenez une clé API et diffusez votre premier audio en quelques minutes.
