Mihu Voice ist unser eigener Sprach-Stack, gebaut für Live-Anrufe: Umay wandelt Sprache in Text um, während der Anrufer noch spricht, und Ses verwandelt Text in natürliche Sprache in sieben Sprachen. Eine API, gehostet in Europa oder der Türkei oder auf Ihren eigenen Servern.
mihu-umay-v1 für Speech-to-Text und mihu-ses-v1 für Text-to-Speech laufen hinter einem API-Schlüssel, über REST und WebSocket. Beide antworten in jeder Region gleich und funktionieren mit den offiziellen OpenAI SDKs, wenn Sie nur die Base-URL ändern.
Teiltext wird gestreamt, während die Person spricht. Der finale Satz steht etwa 80 ms nach dem Sprechende bereit, schneller als ein Wimpernschlag, sodass Ihr Agent ohne Pause antworten kann.
Bei türkischer gelesener Sprache erreicht Umay eine Wortfehlerrate von 3.42%, die niedrigste von neun getesteten Systemen. Im reinen Türkisch-Modus verarbeitet ein Server bis zu 256 Live-Anrufe.
Sprecheroptionen werden pro Anfrage aktiviert; deaktiviert bedeutet keine zusätzliche Latenz.
model=umaymodel=umay-streamwebhook_urlnormalizehints, hint_contextmode=normalgender_detectiondiarizespeaker_lockvoice_isolationreference_voiceprintPOST /v1/voiceprints/verifyPOST /v1/audio/isolationBeträge, Daten und Kennzeichen werden als Zahlen geschrieben, was nur etwa 6 ms kostet. Eingebaute Listen von Bezirken und Stadtteilen sowie Ihre eigenen Hotwords steigern die Genauigkeit bei Ortsnamen im Live-Betrieb um 3 bis 8 Punkte.
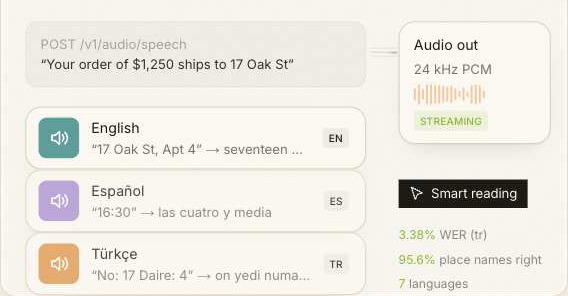
Ses liest Adressen, Ortsnamen, Beträge, Daten, Kennzeichen und Telefonnummern so, wie Menschen sie aussprechen, in allen sieben Sprachen. Das Audio wird gestreamt, bevor der ganze Satz synthetisiert ist, und beginnt nach etwa 0.1 s.
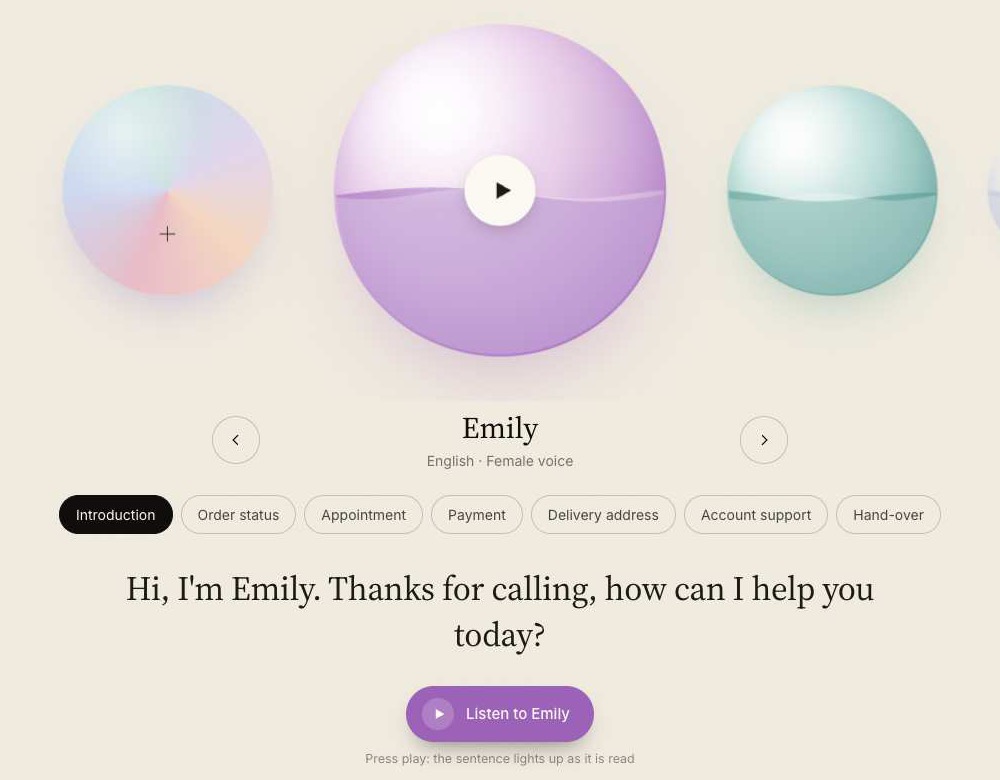
Nehmen Sie eine kurze Probe auf, und Ses erstellt eine eigene Stimme, die Sie neben den 22 integrierten nutzen können. Jeder Klon durchläuft eine Leseprüfung und erfordert die Einwilligung des Sprechers. Die Aufnahme dient nur zum Erstellen der Stimme und wird danach verworfen; gespeichert wird nur die Stimme selbst.
Stimme in der Konsole klonenJedes System wird auf öffentlichen Testsets gleich bewertet, Zahlen und Formate normalisiert. Niedrigere Wortfehlerrate ist besser.
| Sprache | Wortfehlerrate | Wortgenauigkeit |
|---|---|---|
| Türkçe | 3.42% | 96.58% |
| English | 6.44% | 93.56% |
| Deutsch | 6.46% | 93.54% |
| Français | 6.70% | 93.30% |
| Español | 3.68% | 96.32% |
| Italiano | 3.34% | 96.66% |
| Русский | 5.61% | 94.39% |
| Sprache | Wortfehlerrate | Wortgenauigkeit |
|---|---|---|
| Türkçe | 3.38% | 96.62% |
| English | 1.29% | 98.71% |
| Deutsch | 3.62% | 96.38% |
| Français | 4.41% | 95.59% |
| Español | 2.53% | 97.47% |
| Italiano | 3.36% | 96.64% |
| Русский | 5.04% | 94.96% |
Türkisch wird zusätzlich auf Telefonaten und Rundfunkaufnahmen gemessen. Methoden, alle getesteten Systeme und die vollständigen Diagramme finden Sie auf der Benchmark-Seite. Alle Benchmarks →
Stimmen testen, transkribieren, klonen und Schlüssel verwalten, ohne Code zu schreiben. Und Sie entscheiden, wie lange etwas gespeichert bleibt.
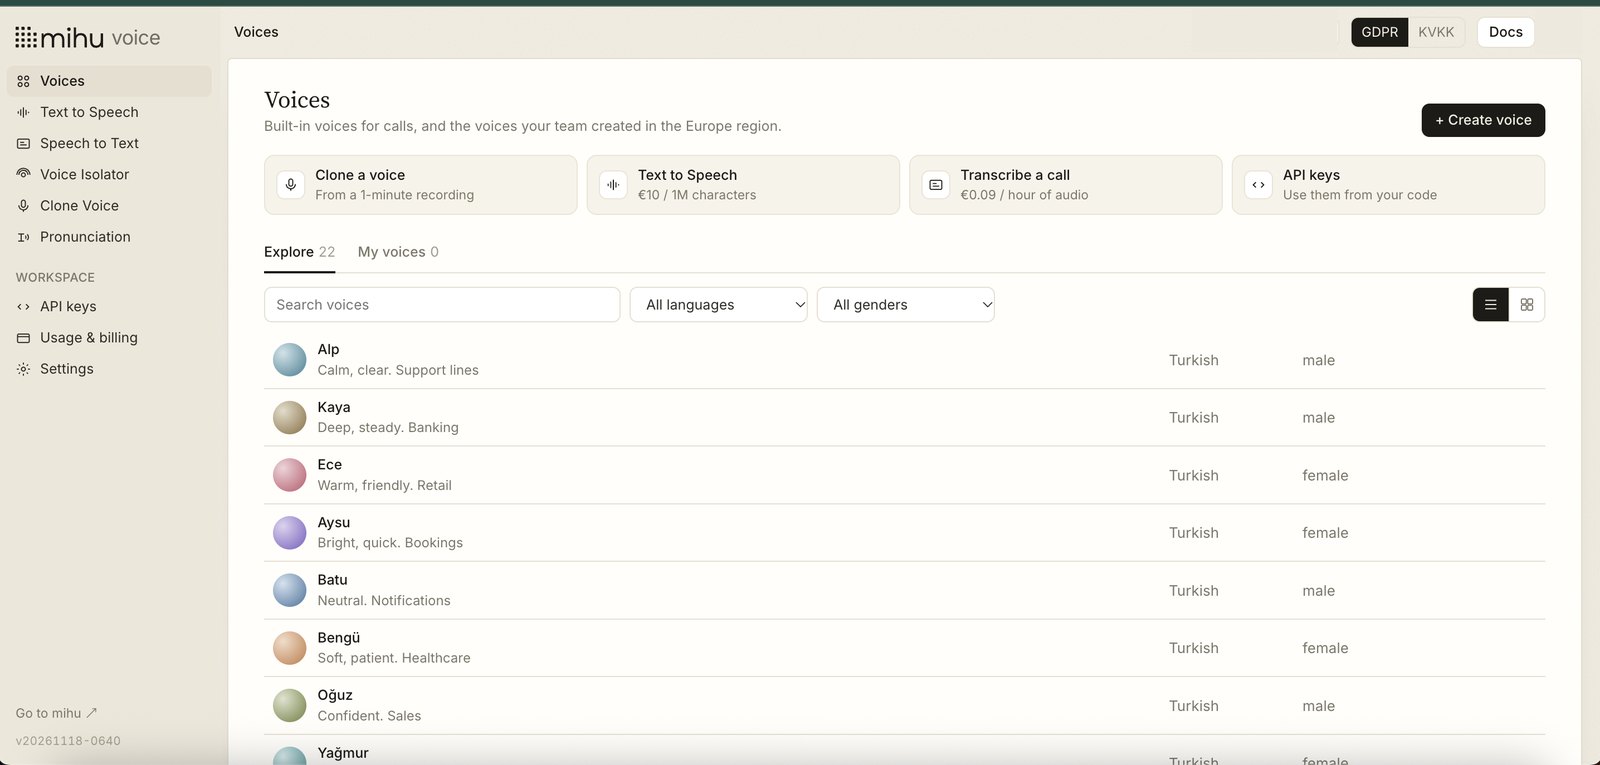
Die integrierten Stimmen und Ihre eigenen. Hören Sie sich jede an, bevor Sie sie verwenden.
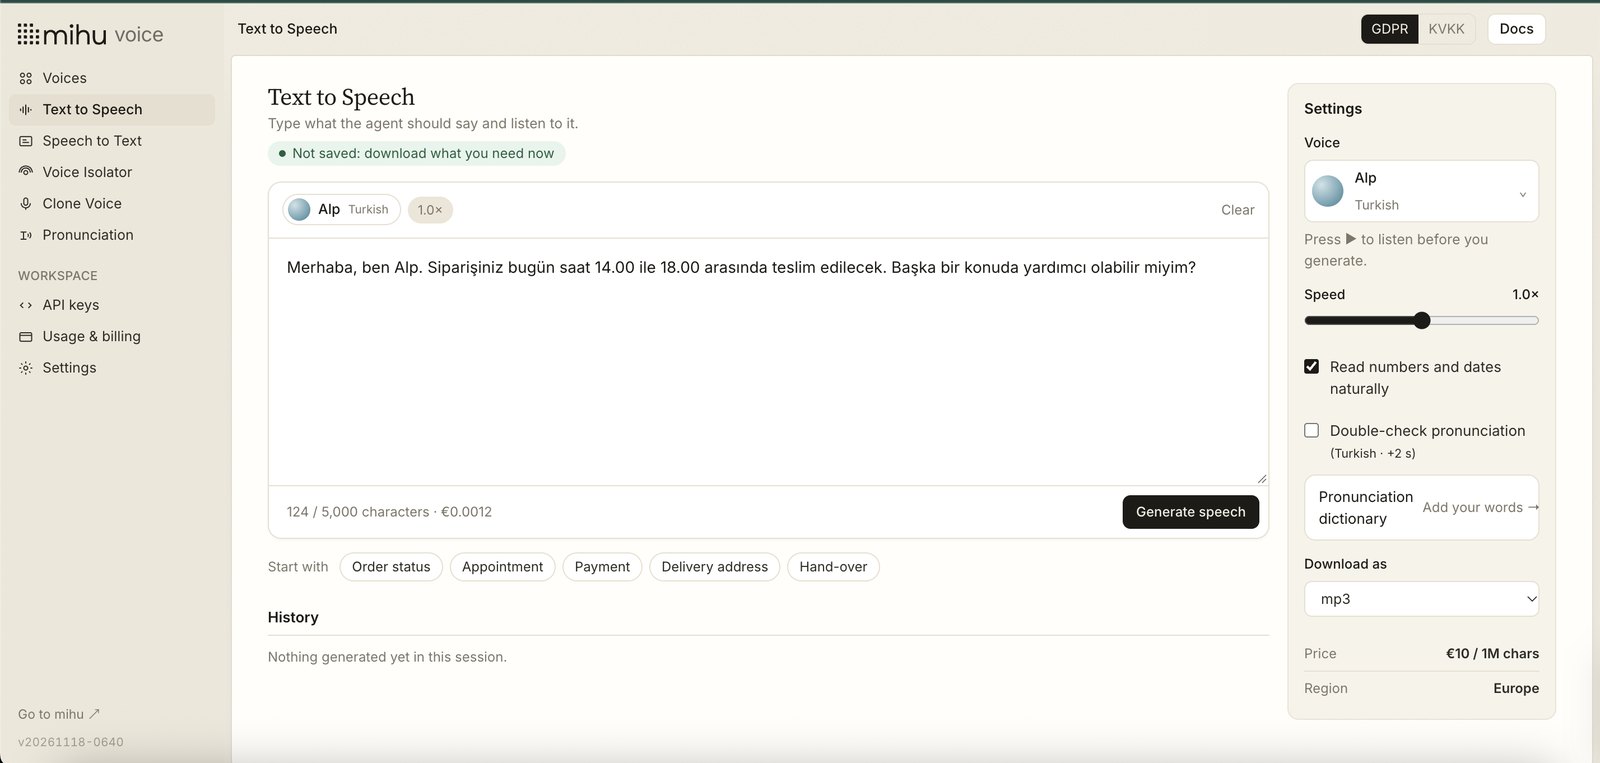
Text eingeben, Stimme wählen und nach etwa 0.1 s hören. Download als mp3, wav, flac und mehr.
Datei oder Link hochladen, aufnehmen oder live gehen und zusehen, wie die Wörter beim Sprechen erscheinen.
Hintergrundstimmen und Störgeräusche aus einer Aufnahme entfernen; vorher und nachher vergleichen.
Eine Stimme aus 10–30 Sekunden Sprache, mit Leseprüfung und Einwilligung des Sprechers.
Schlüssel für Ihre Server, Schnellstart-Code pro Region und Ihre bisherigen Ausgaben.
Es ist kein Mihu SDK nötig, und auf Ihrer Seite läuft nichts. Live-Anrufe streamen Audio über einen WebSocket; Dateien und Synthese nutzen einfaches HTTPS. Die Wahl der Region ändert nur den Host.
import asyncio, json, websockets

URL = "wss://stt.eu.mihu.ai/v1/stream?model=umay-stream&language=tr&api_key=KEY"

async def transcribe(chunks):  # 100 ms of 16 kHz mono int16 PCM
    async with websockets.connect(URL, max_size=None) as ws:
        async def read():
            async for m in ws:
                d = json.loads(m)
                if d["type"] == "final":
                    print(d["text"])  # send this to your LLM
        reader = asyncio.create_task(read())
        for chunk in chunks:
            await ws.send(chunk)
        await ws.send(json.dumps({"event": "end"}))
await readerLive-Streams werden im Arbeitsspeicher verarbeitet und nie auf die Festplatte geschrieben. Eine Datei wird nur während der Transkription vorgehalten.
API-Ergebnisse werden an Sie zurückgegeben, nicht aufbewahrt. In der Konsole wählen Sie, wie lange Transkripte gespeichert bleiben, von gar nicht bis 3 Jahre.
Sprachaufnahmen werden nie gespeichert. Nur eine numerische Signatur wird aufbewahrt, und nur, wenn Sie es wünschen; sie kann endgültig gelöscht werden.
Listenpreise in Euro. Optionen werden separat abgerechnet, nur wenn Sie sie nutzen. Dateien und Live-Streams kosten gleich viel.
| Workload | Volumen | Kosten |
|---|---|---|
| 10,000 Anrufe à 3 Minuten transkribieren | 500 Stunden Audio | €45.00 |
| 10,000 Antworten à 200 Zeichen vertonen | 2 Millionen Zeichen | €20.00 |
| 1,000 Stunden Aufzeichnungen transkribieren | 1,000 Stunden Audio | €90.00 |
| 10,000 Anrufe à 3 Minuten mit Sprecher-Diarisierung | 500 Stunden + 10,000 Gespräche | €145.00 |
On-Premise-Betrieb oder höheres Volumen? Vertrieb kontaktieren →
Hören Sie sich die Stimmen an, transkribieren Sie einen Anruf in der Konsole oder holen Sie sich einen API-Schlüssel und streamen Sie Ihr erstes Audio in wenigen Minuten.
