Mihu Voice هي منظومة الكلام الخاصة بنا، المصمّمة للمكالمات المباشرة: يحوّل Umay الكلام إلى نص بينما لا يزال المتصل يتحدث، ويحوّل Ses النص إلى كلام طبيعي بسبع لغات. API واحدة، مستضافة في أوروبا أو تركيا، أو على خوادمك الخاصة.
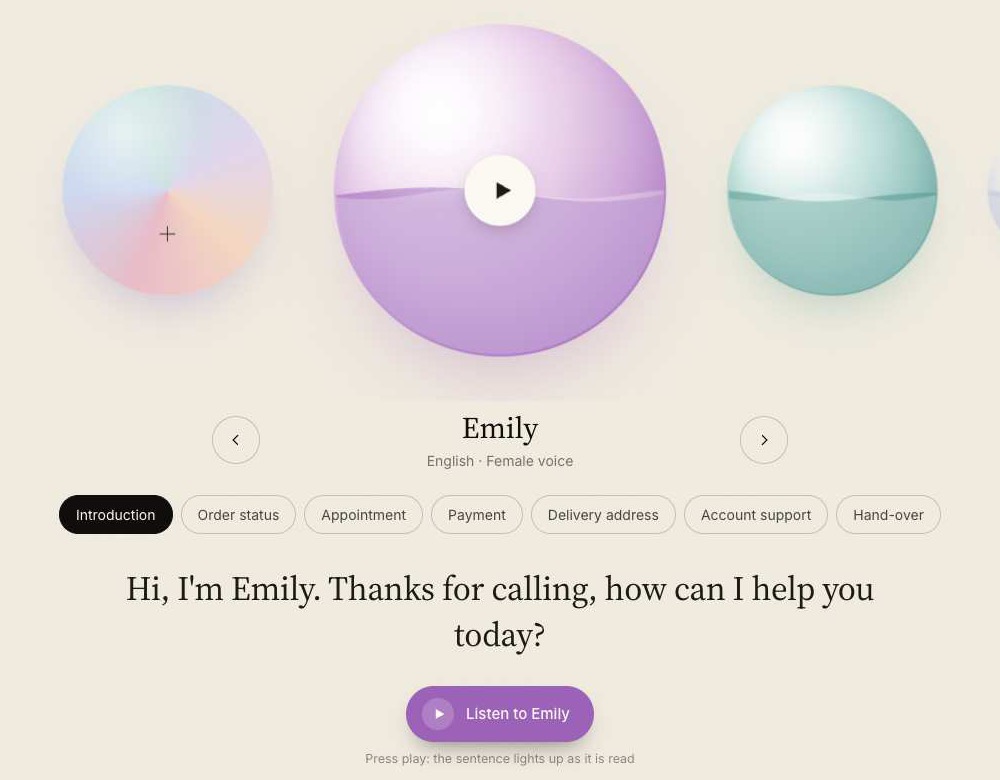
يعمل mihu-umay-v1 لتحويل الكلام إلى نص وmihu-ses-v1 لتحويل النص إلى كلام بمفتاح API واحد، عبر REST وWebSocket. يستجيب كلاهما بالطريقة نفسها في كل منطقة، ويعملان مع حزم OpenAI SDK الرسمية بمجرد تغيير عنوان URL الأساسي.
يتدفق النص الجزئي أثناء حديث الشخص. وتجهز الجملة النهائية بعد نحو 80 ms من توقفه، أسرع من رمشة عين، فيتمكن وكيلك من الرد دون توقف.
على الكلام التركي المقروء، يبلغ معدل خطأ الكلمات لدى Umay نسبة 3.42%، وهو الأدنى بين تسعة أنظمة اختبرناها. وفي وضع التركية فقط، يتعامل خادم واحد مع ما يصل إلى 256 مكالمة مباشرة.
تُفعَّل خيارات المتحدث لكل طلب على حدة؛ وعند إيقافها لا يُضاف أي زمن استجابة.
model=umaymodel=umay-streamwebhook_urlnormalizehints, hint_contextmode=normalgender_detectiondiarizespeaker_lockvoice_isolationreference_voiceprintPOST /v1/voiceprints/verifyPOST /v1/audio/isolationتُكتب المبالغ والتواريخ ولوحات المركبات بالأرقام، مع إضافة نحو 6 ms فقط. وترفع قوائم الأحياء والمناطق المدمجة، إلى جانب كلماتك المفتاحية الخاصة، دقة أسماء الأماكن في الوقت الفعلي بمقدار 3 إلى 8 نقاط.
يقرأ Ses العناوين وأسماء الأماكن والمبالغ والتواريخ ولوحات المركبات وأرقام الهواتف كما ينطقها الناس، باللغات السبع جميعها. ويبدأ بث الصوت قبل اكتمال تركيب الجملة كلها، وينطلق خلال نحو 0.1 s.
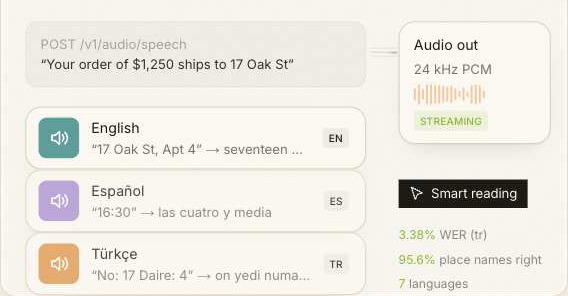
سجّل عينة قصيرة وسيبني Ses صوتاً مخصصاً يمكنك استخدامه إلى جانب الأصوات المدمجة الـ 22. يخضع كل صوت مستنسخ لاختبار قراءة ويتطلب موافقة المتحدث. يُستخدم التسجيل لبناء الصوت ثم يُحذف؛ ولا يُحتفظ إلا بالصوت نفسه.
استنسخ صوتاً في وحدة التحكمتُقيَّم كل الأنظمة بالطريقة نفسها على مجموعات اختبار عامة، مع توحيد الأرقام والصيغ. كلما انخفض معدل خطأ الكلمات كان أفضل.
| اللغة | معدل خطأ الكلمات | دقة الكلمات |
|---|---|---|
| Türkçe | 3.42% | 96.58% |
| English | 6.44% | 93.56% |
| Deutsch | 6.46% | 93.54% |
| Français | 6.70% | 93.30% |
| Español | 3.68% | 96.32% |
| Italiano | 3.34% | 96.66% |
| Русский | 5.61% | 94.39% |
| اللغة | معدل خطأ الكلمات | دقة الكلمات |
|---|---|---|
| Türkçe | 3.38% | 96.62% |
| English | 1.29% | 98.71% |
| Deutsch | 3.62% | 96.38% |
| Français | 4.41% | 95.59% |
| Español | 2.53% | 97.47% |
| Italiano | 3.36% | 96.64% |
| Русский | 5.04% | 94.96% |
قيست التركية أيضًا على مكالمات هاتفية وتسجيلات بث. الطرق وجميع الأنظمة المختبرة والرسوم البيانية الكاملة في صفحة المقارنات. جميع المقارنات المعيارية ←
جرّب الأصوات، وفرّغ التسجيلات، واستنسخ الأصوات، وأدِر المفاتيح دون كتابة أي كود. وأنت من يقرر مدة الاحتفاظ بأي شيء.
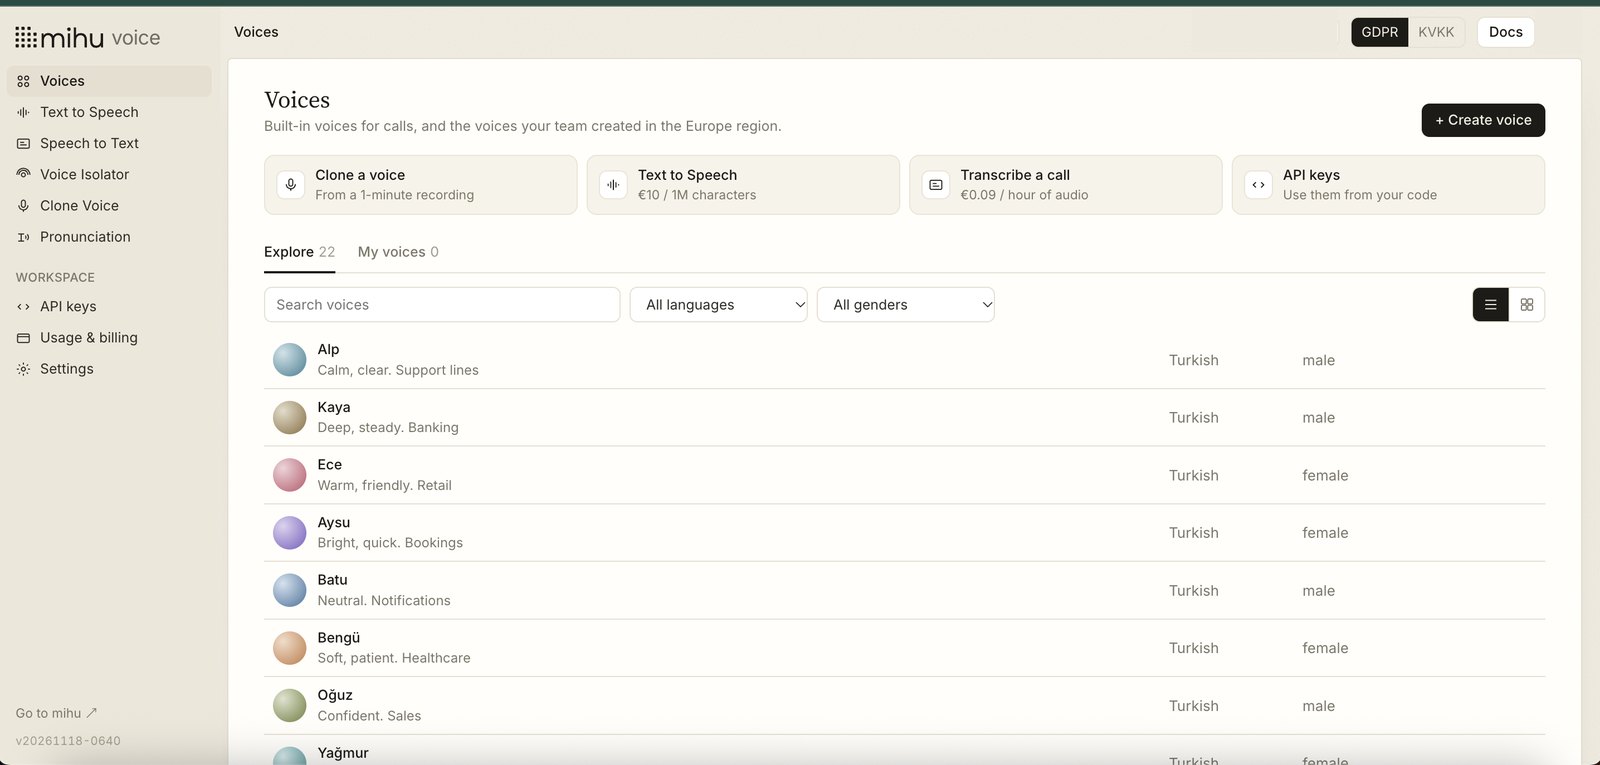
الأصوات المدمجة وأصواتك الخاصة. استمع إلى أي منها قبل استخدامه.
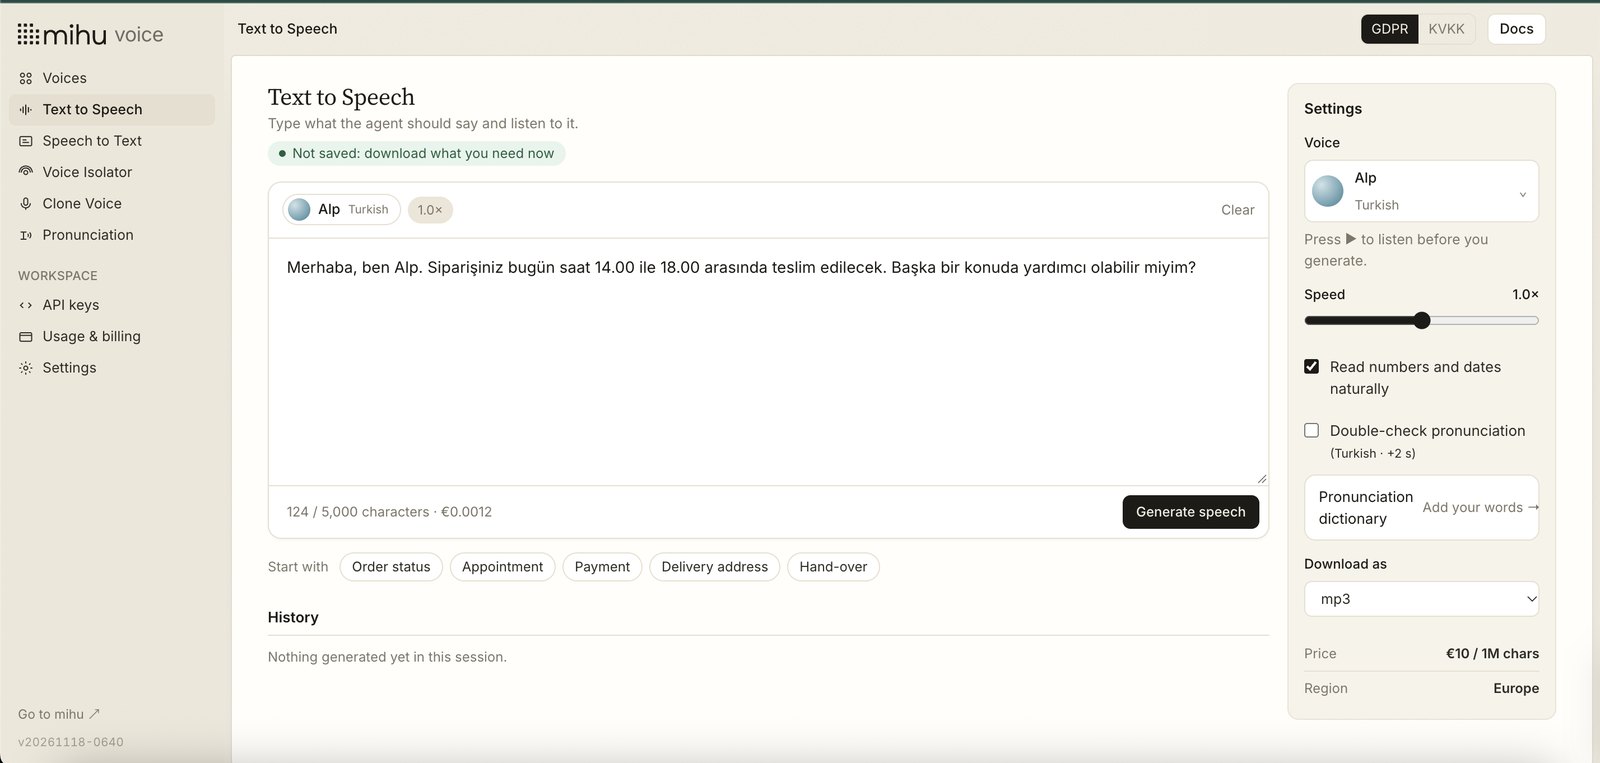
اكتب، واختر صوتاً، واسمعه يبدأ خلال نحو 0.1 s. نزّله بصيغة mp3 أو wav أو flac وغيرها.
ارفع ملفاً أو رابطاً، أو سجّل، أو انتقل إلى البث المباشر وشاهد الكلمات تظهر أثناء حديثك.
أزل الأصوات الخلفية والضوضاء من التسجيل؛ وقارن قبل وبعد.
صوت من 10–30 ثانية من الكلام، مع اختبار قراءة وموافقة المتحدث.
مفاتيح لخوادمك، وكود بدء سريع لكل منطقة، وما أنفقته.
لا حاجة إلى Mihu SDK ولا يعمل أي شيء من جهتك. تبث المكالمات المباشرة الصوت عبر WebSocket؛ وتستخدم الملفات والتركيب HTTPS العادي. واختيار المنطقة لا يغيّر سوى المضيف.
import asyncio, json, websockets

URL = "wss://stt.eu.mihu.ai/v1/stream?model=umay-stream&language=tr&api_key=KEY"

async def transcribe(chunks):  # 100 ms of 16 kHz mono int16 PCM
    async with websockets.connect(URL, max_size=None) as ws:
        async def read():
            async for m in ws:
                d = json.loads(m)
                if d["type"] == "final":
                    print(d["text"])  # send this to your LLM
        reader = asyncio.create_task(read())
        for chunk in chunks:
            await ws.send(chunk)
        await ws.send(json.dumps({"event": "end"}))
await readerتُعالَج البثوث المباشرة في الذاكرة ولا تُكتب على القرص أبداً. ولا يُحتفظ بالملف إلا أثناء تفريغه.
تُعاد نتائج API إليك ولا يُحتفظ بها. وفي وحدة التحكم تختار مدة بقاء النصوص المفرّغة، من عدم الاحتفاظ إطلاقاً حتى 3 سنوات.
لا تُخزَّن التسجيلات الصوتية أبداً. يُحتفظ فقط بتوقيع رقمي، وفقط إذا طلبته؛ ويمكن حذفه نهائياً.
أسعار القائمة باليورو. تُحتسب الخيارات بشكل منفصل، فقط عند استخدامها. وتكلفة الملفات والبث المباشر واحدة.
| حمل العمل | الحجم | التكلفة |
|---|---|---|
| تفريغ 10,000 مكالمة مدة كل منها 3 دقائق | 500 ساعة صوت | €45.00 |
| نطق 10,000 رد طول كل منها 200 حرف | 2 مليون حرف | €20.00 |
| تفريغ 1,000 ساعة من التسجيلات | 1,000 ساعة صوت | €90.00 |
| 10,000 مكالمة مدة كل منها 3 دقائق مع تمييز المتحدثين | 500 ساعة + 10,000 محادثة | €145.00 |
تعمل on-prem أو بأحجام أكبر؟ تحدّث إلى فريق المبيعات ←
استمع إلى الأصوات، أو فرّغ مكالمة في وحدة التحكم، أو احصل على مفتاح API وابدأ بث أول صوت خلال دقائق.
