Mihu Voice è il nostro stack vocale proprietario, creato per le chiamate dal vivo: Umay trasforma la voce in testo mentre l'interlocutore sta ancora parlando, e Ses trasforma il testo in voce naturale in sette lingue. Una sola API, ospitata in Europa o in Turchia, oppure sui vostri server.
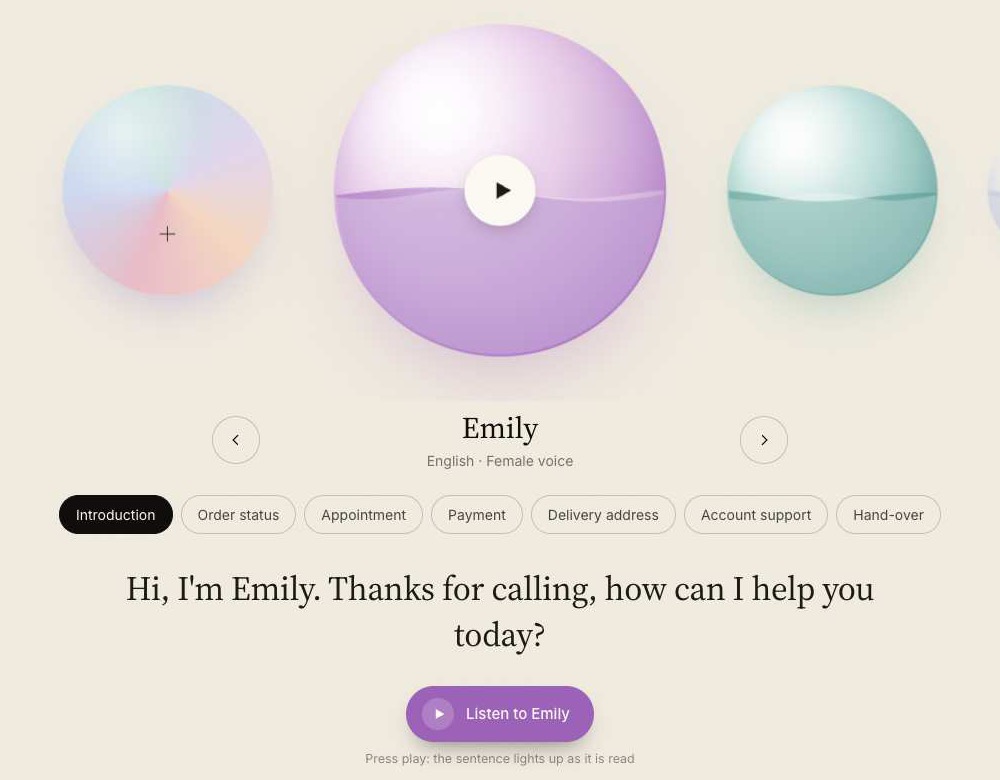
mihu-umay-v1 per il riconoscimento vocale e mihu-ses-v1 per la sintesi vocale funzionano con una sola chiave API, tramite REST e WebSocket. Entrambi rispondono allo stesso modo in ogni regione e funzionano con gli SDK ufficiali di OpenAI cambiando solo il base URL.
Il testo parziale arriva in streaming mentre la persona parla. La frase finale è pronta circa 80 ms dopo che ha smesso, più veloce di un battito di ciglia, così il vostro agente può rispondere senza pause.
Sul parlato letto in turco Umay ha un tasso di errore sulle parole del 3.42%, il più basso tra i nove sistemi che abbiamo testato. In modalità solo turco un server gestisce fino a 256 chiamate dal vivo.
Le opzioni sui parlanti si attivano per singola richiesta; se disattivate non aggiungono latenza.
model=umaymodel=umay-streamwebhook_urlnormalizehints, hint_contextmode=normalgender_detectiondiarizespeaker_lockvoice_isolationreference_voiceprintPOST /v1/voiceprints/verifyPOST /v1/audio/isolationImporti, date e targhe vengono scritti in cifre, con circa 6 ms in più. Elenchi integrati di distretti e quartieri, insieme alle vostre hotword, migliorano da 3 a 8 punti l'accuratezza dei nomi di luogo dal vivo.
Ses legge indirizzi, nomi di luoghi, importi, date, targhe e numeri di telefono come li dicono le persone, in tutte e sette le lingue. L'audio arriva in streaming prima che l'intera frase sia sintetizzata e parte in circa 0.1 s.
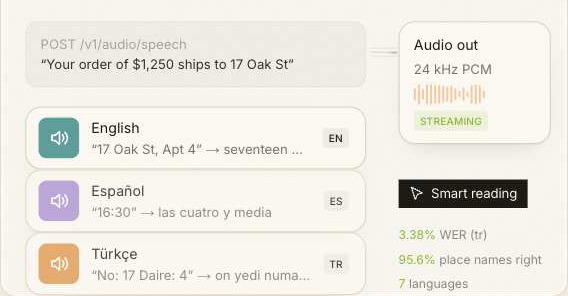
Registrate un breve campione e Ses crea una voce personalizzata da usare accanto alle 22 integrate. Ogni clone passa un controllo di lettura e richiede il consenso del parlante. La registrazione serve a creare la voce e poi viene eliminata; si conserva solo la voce.
Clona una voce nella consoleOgni sistema è valutato allo stesso modo su set di test pubblici, con numeri e formati normalizzati. Un tasso di errore sulle parole più basso è migliore.
| Lingua | Tasso di errore sulle parole | Accuratezza delle parole |
|---|---|---|
| Türkçe | 3.42% | 96.58% |
| English | 6.44% | 93.56% |
| Deutsch | 6.46% | 93.54% |
| Français | 6.70% | 93.30% |
| Español | 3.68% | 96.32% |
| Italiano | 3.34% | 96.66% |
| Русский | 5.61% | 94.39% |
| Lingua | Tasso di errore sulle parole | Accuratezza delle parole |
|---|---|---|
| Türkçe | 3.38% | 96.62% |
| English | 1.29% | 98.71% |
| Deutsch | 3.62% | 96.38% |
| Français | 4.41% | 95.59% |
| Español | 2.53% | 97.47% |
| Italiano | 3.36% | 96.64% |
| Русский | 5.04% | 94.96% |
Il turco è misurato anche su telefonate e media trasmessi. Metodi, sistemi testati e grafici completi sono nella pagina dei benchmark. Tutti i benchmark →
Provate le voci, trascrivete, clonate e gestite le chiavi senza scrivere codice. E siete voi a decidere per quanto tempo viene conservato ogni dato.
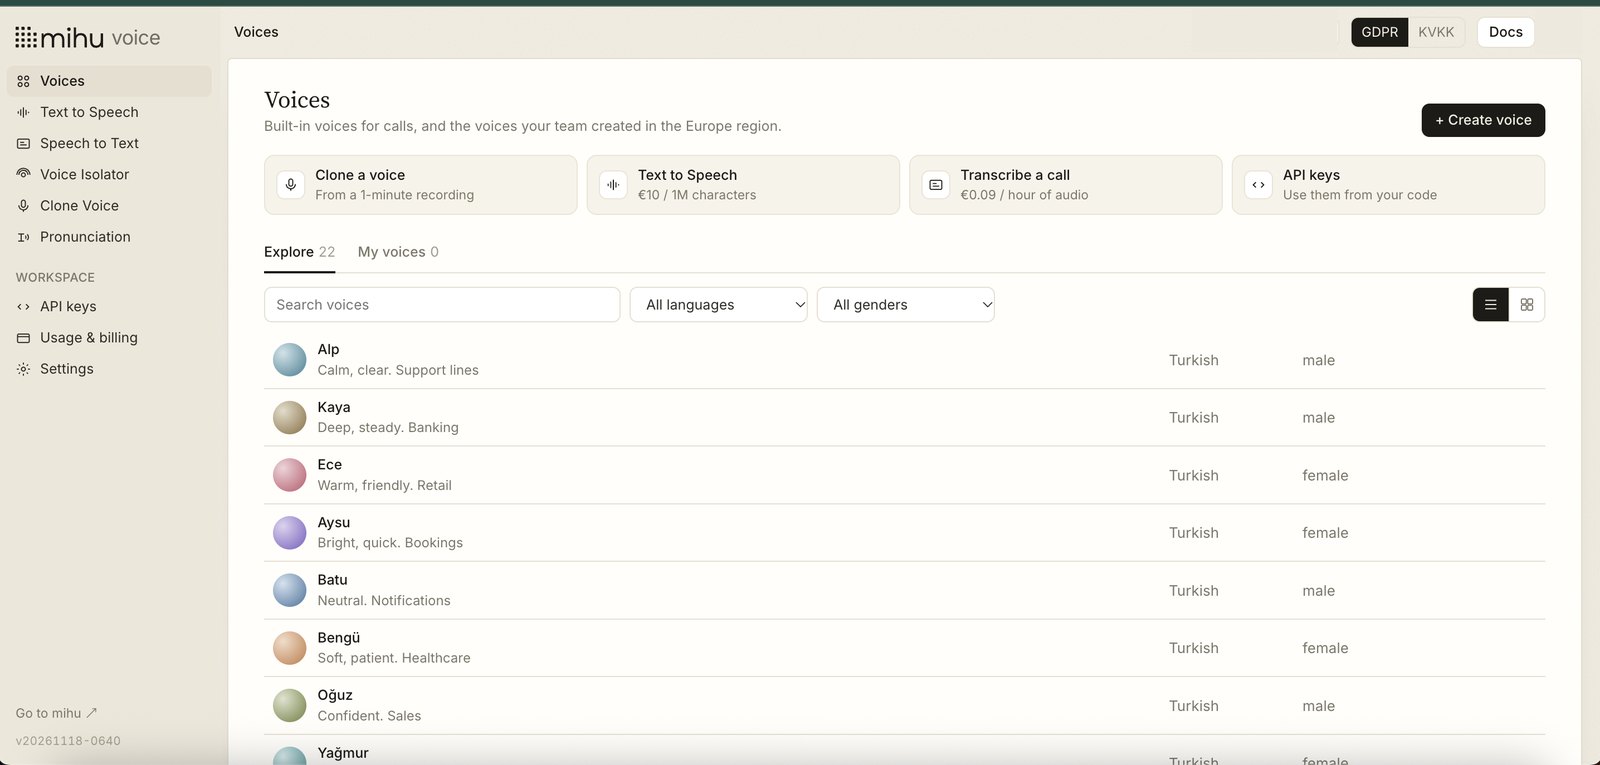
Le voci integrate e le vostre. Ascoltatele prima di usarle.
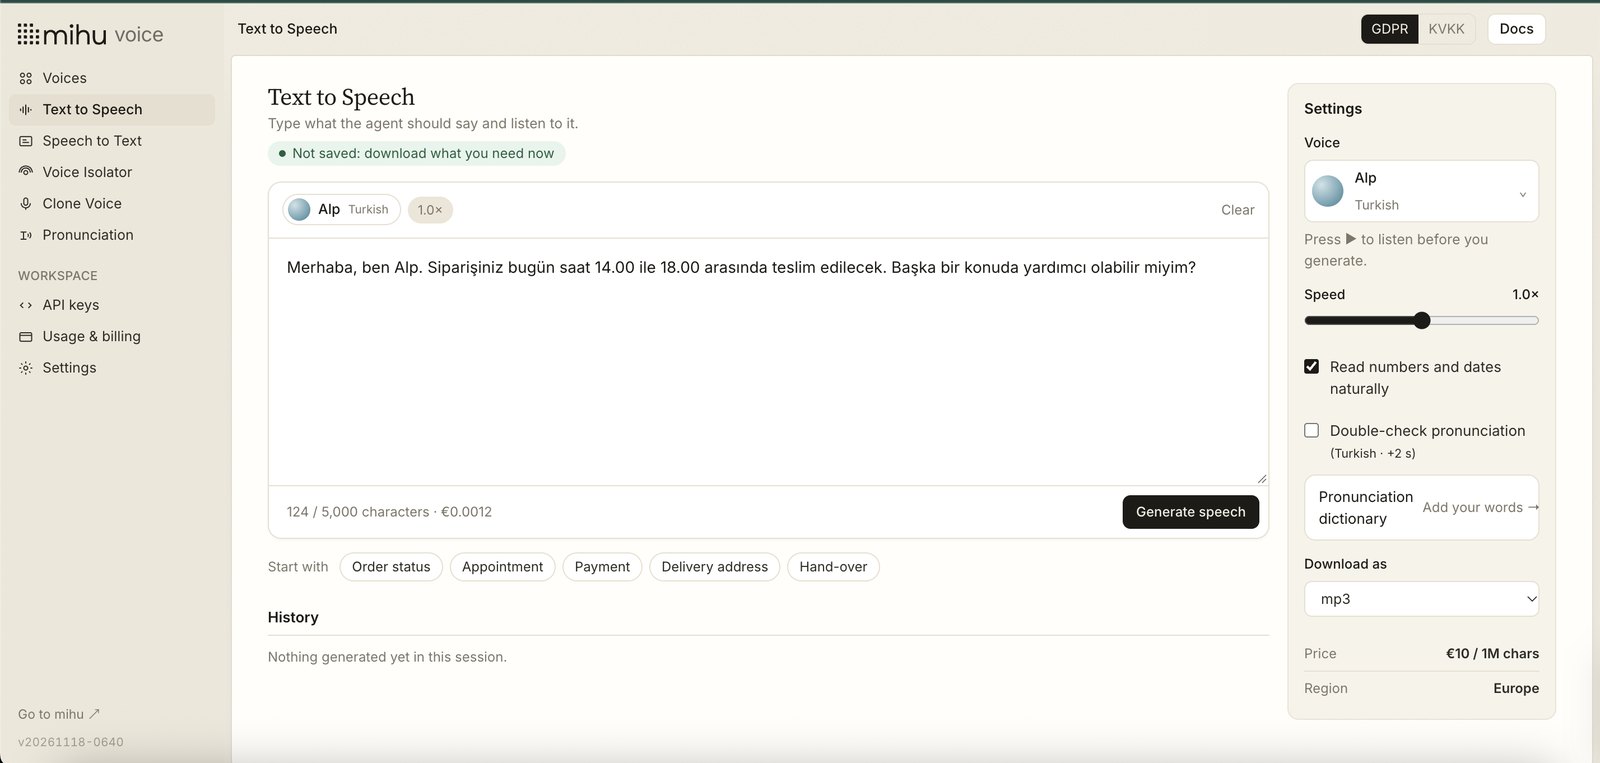
Scrivete, scegliete una voce e sentitela partire in circa 0.1 s. Download in mp3, wav, flac e altri formati.
Caricate un file o un link, registrate, oppure andate dal vivo e guardate le parole comparire mentre parlate.
Rimuovete voci di sottofondo e rumore da una registrazione; confrontate il prima e il dopo.
Una voce da 10–30 secondi di parlato, con controllo di lettura e consenso del parlante.
Chiavi per i vostri server, codice di avvio rapido per regione e quanto avete speso.
Non serve alcun SDK Mihu e nulla viene eseguito dal vostro lato. Le chiamate dal vivo trasmettono l'audio su un WebSocket; file e sintesi usano semplice HTTPS. Scegliere una regione cambia solo l'host.
import asyncio, json, websockets

URL = "wss://stt.eu.mihu.ai/v1/stream?model=umay-stream&language=tr&api_key=KEY"

async def transcribe(chunks):  # 100 ms of 16 kHz mono int16 PCM
    async with websockets.connect(URL, max_size=None) as ws:
        async def read():
            async for m in ws:
                d = json.loads(m)
                if d["type"] == "final":
                    print(d["text"])  # send this to your LLM
        reader = asyncio.create_task(read())
        for chunk in chunks:
            await ws.send(chunk)
        await ws.send(json.dumps({"event": "end"}))
await readerGli stream dal vivo sono elaborati in memoria e mai scritti su disco. Un file viene conservato solo durante la trascrizione.
I risultati dell'API vengono restituiti a voi, non conservati. Nella console scegliete per quanto tempo restano le trascrizioni, da nessuna conservazione fino a 3 anni.
Le registrazioni vocali non vengono mai archiviate. Si conserva solo una firma numerica, e solo se lo richiedete; può essere eliminata definitivamente.
Prezzi di listino in euro. Le opzioni sono fatturate a parte, solo quando le usate. File e stream dal vivo costano uguale.
| Carico di lavoro | Volume | Costo |
|---|---|---|
| Trascrivere 10,000 chiamate da 3 minuti | 500 ore di audio | €45.00 |
| Pronunciare 10,000 risposte da 200 caratteri | 2 milioni di caratteri | €20.00 |
| Trascrivere 1,000 ore di registrazioni | 1,000 ore di audio | €90.00 |
| 10,000 chiamate da 3 minuti con diarizzazione dei parlanti | 500 ore + 10,000 conversazioni | €145.00 |
Deployment on-premise o volumi più elevati? Parla con il team commerciale →
Ascoltate le voci, trascrivete una chiamata nella console oppure ottenete una chiave API e trasmettete il vostro primo audio in pochi minuti.
