Mihu Voice to nasz własny stos mowy, stworzony do rozmów na żywo: Umay zamienia mowę na tekst, gdy rozmówca wciąż mówi, a Ses zamienia tekst w naturalną mowę w siedmiu językach. Jedno API, hosting w Europie lub Turcji albo na Twoich własnych serwerach.
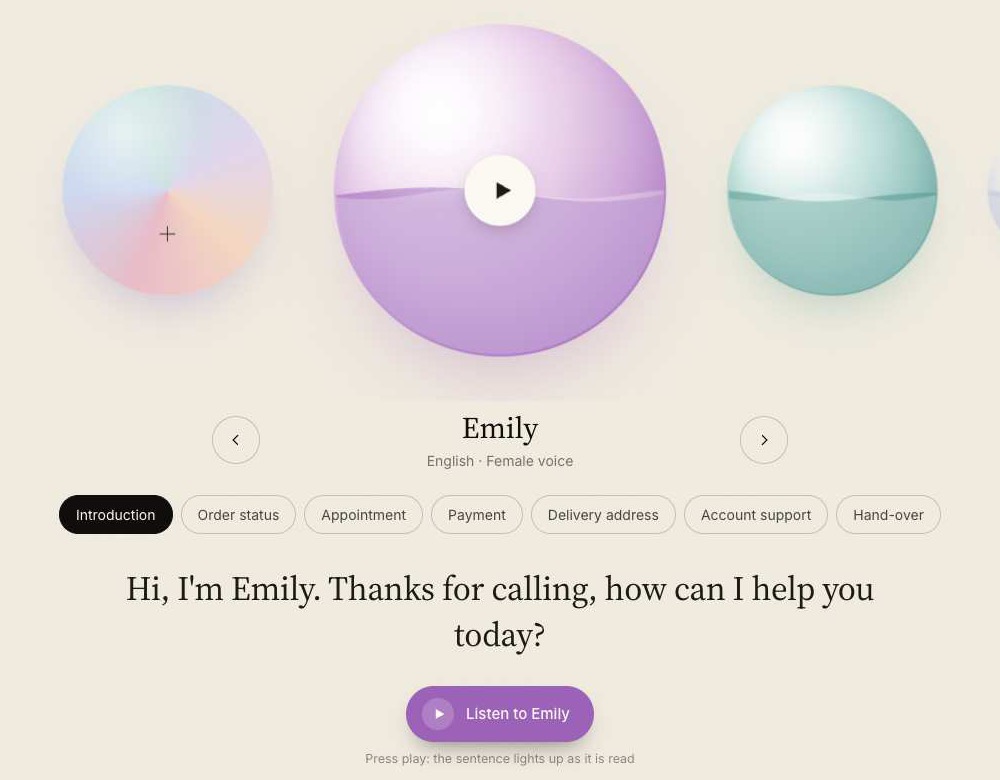
mihu-umay-v1 do zamiany mowy na tekst i mihu-ses-v1 do zamiany tekstu na mowę działają pod jednym kluczem API, przez REST i WebSocket. Oba odpowiadają tak samo w każdym regionie i współpracują z oficjalnymi SDK OpenAI po zmianie base URL.
Tekst częściowy napływa strumieniowo w trakcie mówienia. Zdanie końcowe jest gotowe ok. 80 ms po zakończeniu wypowiedzi, szybciej niż mrugnięcie oka, więc Twój agent odpowiada bez przerwy.
Na tureckiej mowie czytanej Umay osiąga wskaźnik błędów słów 3.42%, najniższy spośród dziewięciu przetestowanych przez nas systemów. W trybie tylko tureckim jeden serwer obsługuje do 256 rozmów na żywo.
Opcje mówców włączasz dla każdego żądania osobno; wyłączone nie dodają opóźnienia.
model=umaymodel=umay-streamwebhook_urlnormalizehints, hint_contextmode=normalgender_detectiondiarizespeaker_lockvoice_isolationreference_voiceprintPOST /v1/voiceprints/verifyPOST /v1/audio/isolationKwoty, daty i numery rejestracyjne są zapisywane cyframi, co dodaje ok. 6 ms. Wbudowane listy dzielnic i osiedli oraz Twoje własne hotwords podnoszą dokładność nazw miejsc na żywo o 3 do 8 punktów.
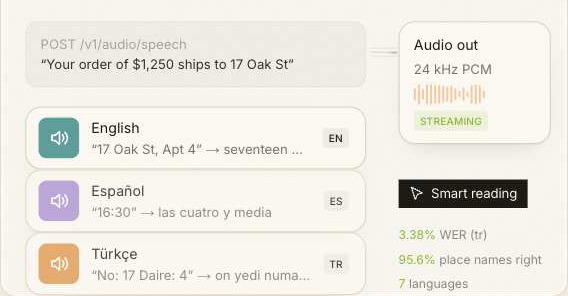
Ses czyta adresy, nazwy miejsc, kwoty, daty, numery rejestracyjne i numery telefonów tak, jak mówią je ludzie, we wszystkich siedmiu językach. Dźwięk wraca strumieniowo, zanim całe zdanie zostanie zsyntetyzowane, i startuje po ok. 0.1 s.
Nagraj krótką próbkę, a Ses zbuduje własny głos, którego użyjesz obok 22 wbudowanych. Każdy klon przechodzi kontrolę czytania i wymaga zgody mówcy. Nagranie służy do zbudowania głosu, a potem jest usuwane; zachowywany jest tylko sam głos.
Sklonuj głos w konsoliKażdy system oceniany jest tak samo na publicznych zbiorach testowych, z normalizacją liczb i formatów. Niższy wskaźnik błędów słów jest lepszy.
| Język | Wskaźnik błędów słów | Dokładność słów |
|---|---|---|
| Türkçe | 3.42% | 96.58% |
| English | 6.44% | 93.56% |
| Deutsch | 6.46% | 93.54% |
| Français | 6.70% | 93.30% |
| Español | 3.68% | 96.32% |
| Italiano | 3.34% | 96.66% |
| Русский | 5.61% | 94.39% |
| Język | Wskaźnik błędów słów | Dokładność słów |
|---|---|---|
| Türkçe | 3.38% | 96.62% |
| English | 1.29% | 98.71% |
| Deutsch | 3.62% | 96.38% |
| Français | 4.41% | 95.59% |
| Español | 2.53% | 97.47% |
| Italiano | 3.36% | 96.64% |
| Русский | 5.04% | 94.96% |
Turecki mierzymy też na rozmowach telefonicznych i nagraniach nadawczych. Metody, wszystkie testowane systemy i pełne wykresy znajdziesz na stronie benchmarków. Wszystkie benchmarki →
Testuj głosy, transkrybuj, klonuj i zarządzaj kluczami bez pisania kodu. A Ty decydujesz, jak długo cokolwiek jest przechowywane.
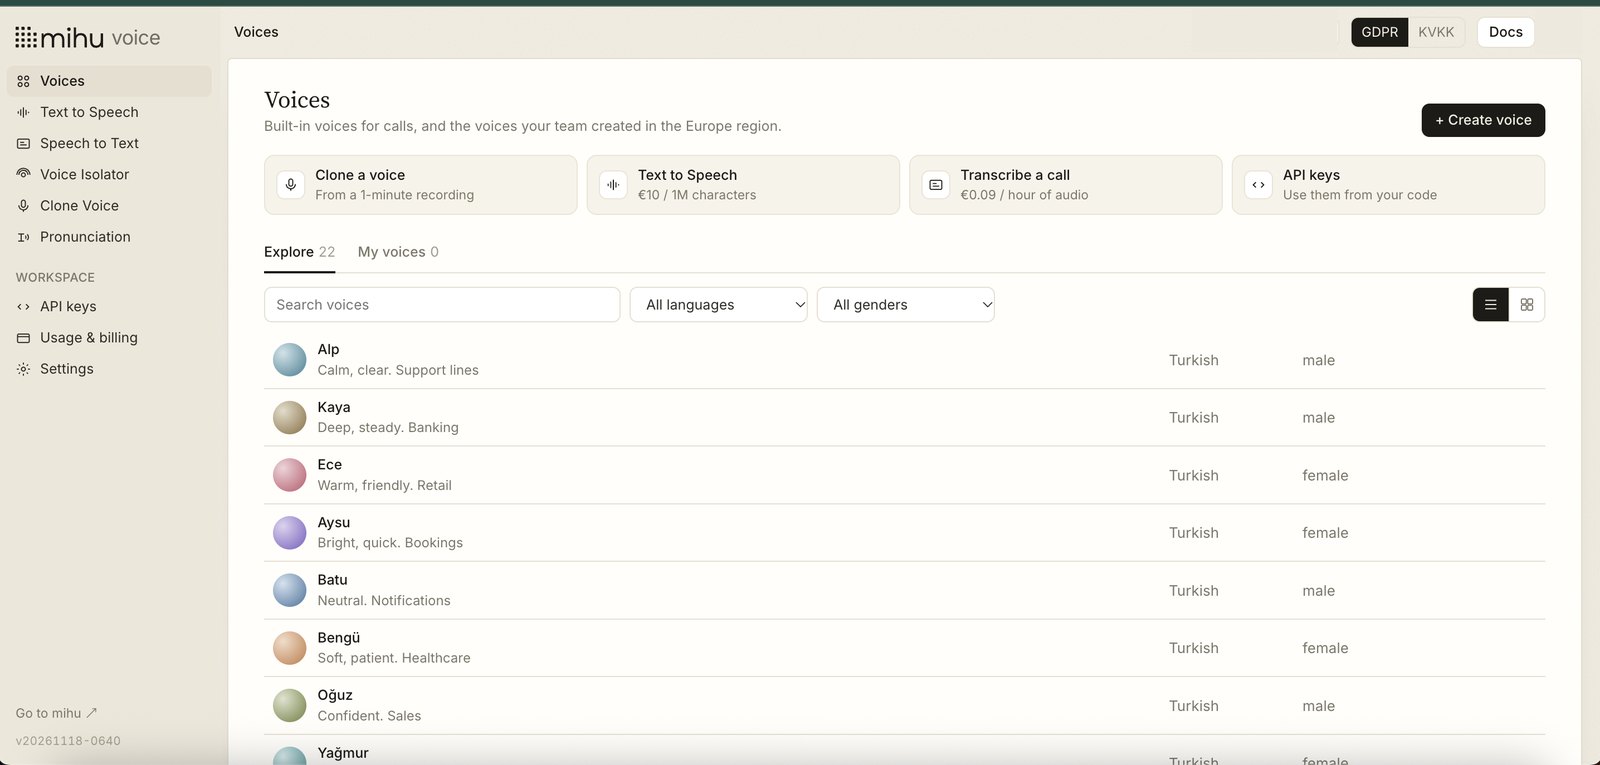
Wbudowane głosy i Twoje własne. Odsłuchaj każdy, zanim go użyjesz.
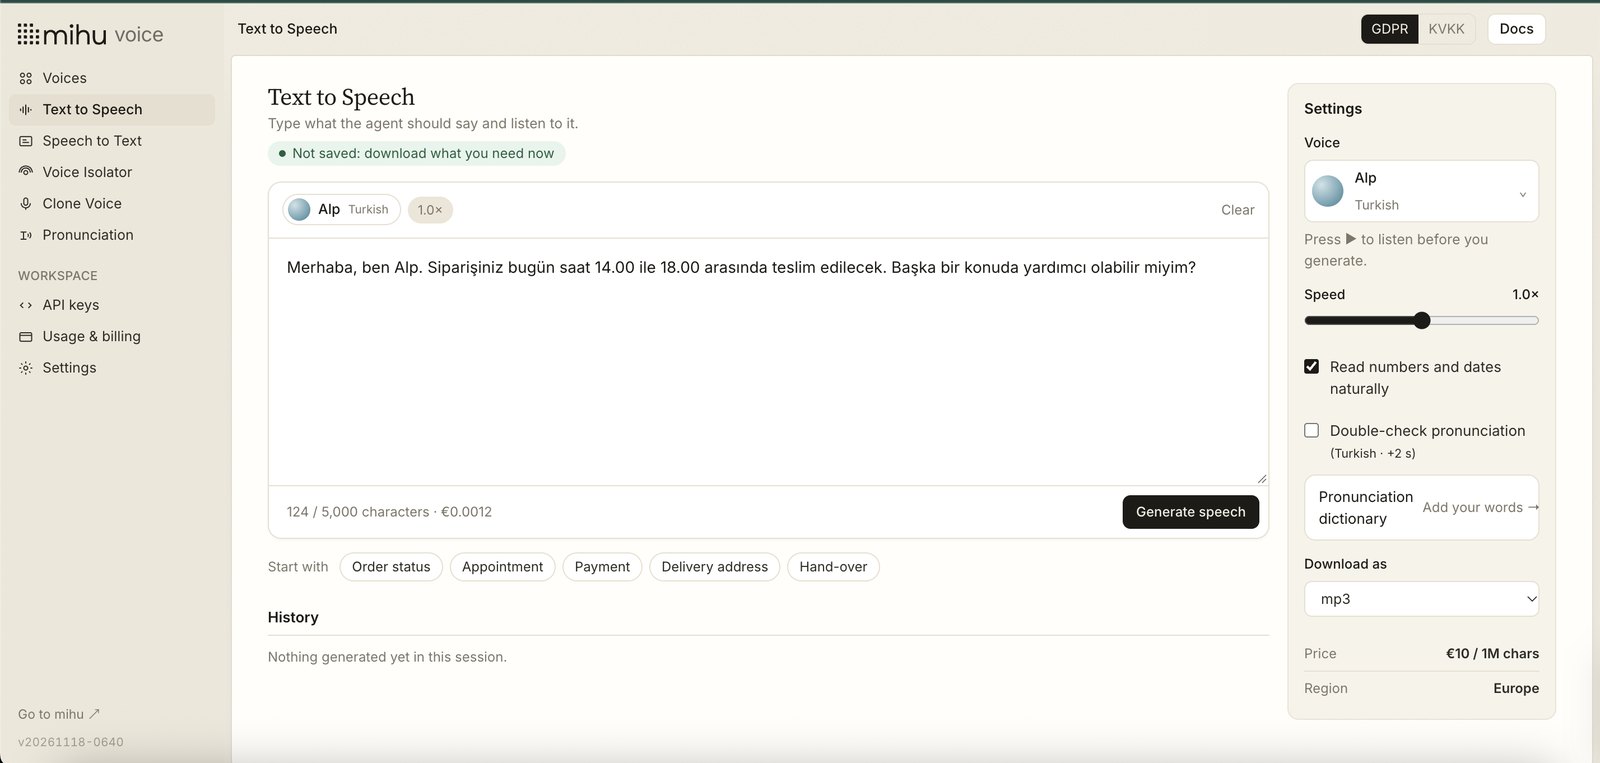
Wpisz tekst, wybierz głos i usłysz go po ok. 0.1 s. Pobierz jako mp3, wav, flac i inne.
Prześlij plik lub link, nagraj albo przejdź na żywo i patrz, jak słowa pojawiają się w trakcie mówienia.
Usuń głosy w tle i szum z nagrania; porównaj przed i po.
Głos z 10–30 sekund mowy, z kontrolą czytania i zgodą mówcy.
Klucze dla Twoich serwerów, kod quick-start dla każdego regionu i Twoje wydatki.
Nie potrzebujesz SDK Mihu i nic nie działa po Twojej stronie. Rozmowy na żywo przesyłają dźwięk przez WebSocket; pliki i synteza używają zwykłego HTTPS. Wybór regionu zmienia tylko host.
import asyncio, json, websockets

URL = "wss://stt.eu.mihu.ai/v1/stream?model=umay-stream&language=tr&api_key=KEY"

async def transcribe(chunks):  # 100 ms of 16 kHz mono int16 PCM
    async with websockets.connect(URL, max_size=None) as ws:
        async def read():
            async for m in ws:
                d = json.loads(m)
                if d["type"] == "final":
                    print(d["text"])  # send this to your LLM
        reader = asyncio.create_task(read())
        for chunk in chunks:
            await ws.send(chunk)
        await ws.send(json.dumps({"event": "end"}))
await readerStrumienie na żywo są przetwarzane w pamięci i nigdy nie trafiają na dysk. Plik jest przechowywany tylko na czas transkrypcji.
Wyniki API są zwracane do Ciebie, a nie przechowywane. W konsoli wybierasz, jak długo zostają transkrypcje: od wcale do 3 lat.
Nagrania głosu nigdy nie są przechowywane. Zachowywana jest tylko sygnatura liczbowa i tylko na Twoją prośbę; można ją trwale usunąć.
Ceny katalogowe w euro. Opcje są rozliczane osobno, tylko gdy z nich korzystasz. Pliki i strumienie na żywo kosztują tyle samo.
| Zadanie | Wolumen | Koszt |
|---|---|---|
| Transkrypcja 10,000 rozmów po 3 minuty | 500 godzin dźwięku | €45.00 |
| Wypowiedzenie 10,000 odpowiedzi po 200 znaków | 2 miliony znaków | €20.00 |
| Transkrypcja 1,000 godzin nagrań | 1,000 godzin dźwięku | €90.00 |
| 10,000 rozmów po 3 minuty z diaryzacją mówców | 500 godzin + 10,000 rozmów | €145.00 |
Wdrożenie on-premise lub większy wolumen? Porozmawiaj z działem sprzedaży →
Posłuchaj głosów, przetranskrybuj rozmowę w konsoli albo pobierz klucz API i prześlij pierwszy strumień audio w kilka minut.
